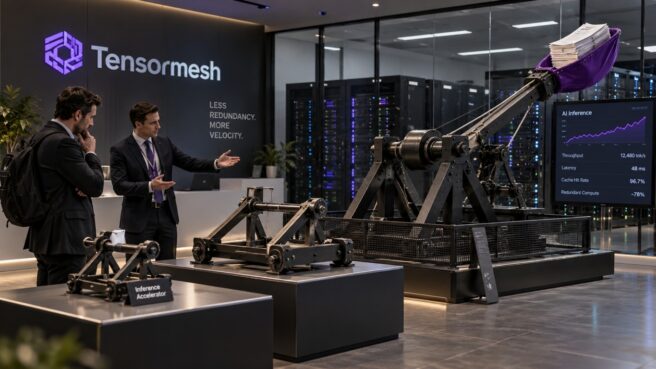

Компания Tensormesh, известная как разработчик открытого решения LMCache, анонсировала запуск одноименной платформы для управления данными при исполнении нейросетевых моделей. Как сообщает издание HPCwire, новая система представляет собой масштабируемый слой управления KV-кэшем, призванный избавить корпоративный сектор от избыточных вычислений в крупномасштабных языковых моделях (LLM).
Проблема, которую пытается решить стартап, кроется в самой архитектуре современных трансформеров: при каждом новом запросе системы зачастую заново пересчитывают один и тот же контекст. Tensormesh Platform развертывается внутри инфраструктуры заказчика через Kubernetes и позволяет повторно использовать уже вычисленные данные, что теоретически должно снизить нагрузку на дорогостоящие графические ускорители.
Механика экономии: от HBM до внешних хранилищ
Техническое решение базируется на многоуровневом подходе. Система автоматически распределяет KV-кэш (Key-Value cache) между высокоскоростной памятью видеокарт (HBM), оперативной памятью центрального процессора и постоянными накопителями. Это позволяет хранить огромные объемы промежуточных данных, не перегружая при этом память GPU, которая остается самым дефицитным ресурсом в современном дата-центре.
Для обеспечения промышленной эксплуатации разработчики интегрировали в платформу инструменты безопасности, мониторинга производительности в реальном времени и механизмы обеспечения отказоустойчивости. Особое внимание уделено мультиарендности (multi-tenancy), что позволяет разным командам внутри одной организации использовать общую инфраструктуру при полной изоляции их данных, предотвращая возможные утечки контекста между проектами.
Генеральный директор Tensormesh Junchen Jiang отмечает, что бесконечное перевычисление одного и того же контекста не только сжигает машинное время, но и увеличивает задержку до появления первого токена (time-to-first-token). Платформа нацелена на то, чтобы сделать повторное использование кэша операционно пригодным для флота серверов любого масштаба, переводя технологию из разряда академических экспериментов в плоскость сурового энтерпрайза.
Экономика ИИ сегодня диктуется не фактом владения GPU, а коэффициентом их полезного использования. Кэширование KV-пар превращает инференс из процесса чистого вычисления в процесс извлечения данных, что критически важно для RAG-систем. Однако архитектурная сложность синхронизации кэша между узлами часто нивелирует выигрыш в скорости, превращая платформу в еще один прожорливый слой абстракции. Если Tensormesh не решит проблему оверхеда на поиск в распределенном индексе, их решение рискует стать просто дорогим пластырем на неэффективных алгоритмах.
Практические возможности и интеграция
Платформа предлагает несколько сценариев оптимизации, которые могут быть знакомы тем, кто пытался самостоятельно «прикрутить» кэширование к vLLM или другим движкам инференса. В частности, реализовано префиксное кэширование для повторяющихся начал промптов и технология CacheBlend, позволяющая находить и использовать вычисленные блоки в любой части запроса.
- Tiered Caching: автоматическое перемещение данных между уровнями памяти;
- P2P Transfer: прямая передача кэша между узлами кластера без обращения к центральному хранилищу;
- Advanced Controls: API для ручного управления жизненным циклом записей — их можно закреплять, сжимать или удалять по требованию.
В проекте уже отметились партнеры из SUSE и Nebius, подчеркивающие, что индустрия переходит от этапа «выбора лучшей модели» к этапу выстраивания эффективной инфраструктуры. Тот факт, что за Tensormesh стоят выходцы из Чикагского университета и Беркли, а объем привлеченных инвестиций достиг $28,5 млн, намекает на серьезность намерений превратить память ИИ в структурированный актив, а не в эфемерный побочный продукт вычислений.
Для внедрения подобных решений обычно требуется четкое понимание структуры ваших запросов. Если ваши LLM-агенты работают с уникальным контекстом в 100% случаев, профит от кэширования будет стремиться к нулю. Однако в сценариях с длинными системными промптами или частыми обращениями к одной и той же базе знаний, подобные инструменты могут стать тем самым фактором, который позволит бюджету на облачные вычисления продержаться до конца квартала.
Оставить комментарий