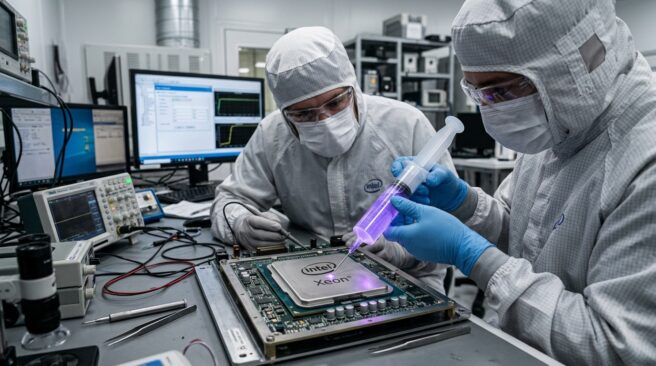

Запуск больших языковых моделей (LLM) на собственном оборудовании часто превращается в многодневный квест по ручной настройке параметров. Согласно сообщению Intel, компания представила Intel Inference Microservices — решение, призванное автоматизировать оптимизацию инференса для своих процессоров, избавляя инженеров от необходимости вручную подбирать конфигурации.
Проблема производительности ИИ на центральных процессорах всегда упиралась в детали: распределение нагрузки по ядрам, топологию NUMA-узлов и использование специфических наборов инструкций. Каждое изменение модели или поколения кремния требовало нового цикла тестирования. Теперь же микросервисы Intel упаковывают модель в контейнер, который при запуске сам определяет тип процессора и применяет валидированные настройки.
Первый релиз ориентирован на серверные процессоры Intel Xeon 4-го, 5-го и 6-го поколений. Это выглядит как попытка Intel создать единый интерфейс для работы с ИИ на всем своем железе. Микросервисы работают через OpenAI-совместимый API, что позволяет интегрировать их в существующие экосистемы вроде LangChain или LlamaIndex простым изменением базового URL-адреса.
Практика: от запуска до первого ответа
Для тех, кто привык проверять технологии в деле, процесс выглядит максимально лаконично. Для запуска, например, модели Qwen3-4B на подходящем сервере с Docker достаточно одной команды. Контейнер самостоятельно проинспектирует среду, найдет доступные ускорители вроде Intel AMX и выберет оптимальный профиль производительности.
- Запуск контейнера:
docker run --rm -p 8000:8000 --cap-add SYS_NICE --shm-size=2g intel/inference-xeon-qwen-qwen3-4b:0.1.0 - Ожидание статуса готовности через эндпоинт /health.
- Отправка стандартного POST-запроса через curl для проверки чат-функционала.
Такой подход устраняет необходимость в глубокой экспертизе по оптимизации инференса. Разработчику не нужно собирать Python-окружение или устанавливать специфические движки — вся магия происходит внутри образа. Если же запустить контейнер на неподдерживаемом железе, система выдаст ошибку, предотвращая работу в неоптимальном режиме.
Попытка Intel превратить сложную настройку инференса в стандартный docker pull выглядит здравым шагом, учитывая дефицит узких специалистов. Однако ориентация на OpenAI API — это одновременно и удобство, и признание того, что рынок уже выбрал стандарты без участия процессорного гиганта. Пока это лишь удобная обертка для Xeon, которая не решает фундаментального отставания CPU в чистой скорости вычислений от специализированных чипов, но делает ИИ доступным там, где серверы уже стоят в стойках.
Технологический фундамент и перспективы
В основе решения лежит движок vLLM, дополненный специфическими оптимизациями Intel, которые компания активно вносит в open-source проекты. Основной прирост скорости обеспечивают инструкции Intel Advanced Matrix Extensions (AMX), предназначенные специально для матричных вычислений, лежащих в основе глубокого обучения.
Бизнес-логика здесь прозрачна: использование уже имеющихся мощностей Xeon позволяет запускать пилотные ИИ-проекты без капитальных затрат на закупку GPU. Поскольку интерфейс остается неизменным, в будущем рабочие нагрузки можно будет перенести на дискретные графические решения Intel, такие как Crescent Island, без переписывания кода приложения.
Вице-президент Intel Билл Пирсон подчеркнул, что компания стремится предоставлять настроенный стек через стандартные API. Это важный сигнал для рынка: Intel пытается сделать переход на свои новые архитектуры бесшовным, предлагая программный слой, который скрывает сложность железа за привычными для веб-разработчиков методами взаимодействия.
Оставить комментарий