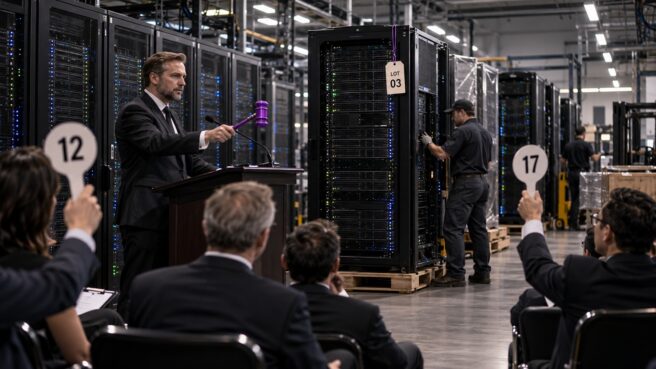

Компания Architect Financial Technologies представила платформу Liquid Inference, представляющую собой специализированный роутер для больших языковых моделей (LLM), работающий по принципу живого аукциона. Как сообщает MarkTechPost, система позволяет провайдерам мощностей конкурировать за выполнение каждого отдельного запроса в режиме реального времени, предлагая наиболее выгодные условия.
Разработчики позиционируют Liquid Inference как маркетплейс, где покупатель автоматически оплачивает самое дешевое предложение, соответствующее заданным критериям качества. Для интеграции решения достаточно сменить базовый URL в коде приложения, сохраняя привычный синтаксис запросов, что делает переход на аукционную модель технически бесшовным.
Механика биржевого инференса
Продукт создан командой с бэкграундом в финансовом трейдинге, а не в классических ИИ-лабораториях, что объясняет необычный подход к ценообразованию. В основе лежит опыт Architect по управлению биржей фьючерсов, перенесенный на рынок вычислительных мощностей. Процесс обработки запроса выглядит следующим образом:
- Клиент отправляет стандартный вызов API, совместимый с протоколами OpenAI или Anthropic.
- Система фильтрует доступные предложения провайдеров согласно правилам, установленным покупателем.
- Среди подходящих вариантов выбирается заявка с минимальной ценой, которая и получает право на исполнение.
- Стоимость фиксируется до начала генерации текста, гарантируя отсутствие скрытых переплат.
Пользователи могут настраивать лимиты стоимости для каждой задачи, устанавливать ограничения по времени до получения первого токена (TTFT) и минимальную пропускную способность. Также доступны фильтры по регионам присутствия серверов, требование Zero Data Retention (нулевое хранение данных) и возможность формирования списков разрешенных провайдеров или моделей.
Преимущества для разработчиков и провайдеров
Для тех, кто использует инструменты вроде Cursor, Claude Code или Pi, платформа предлагает прямую совместимость. Владельцы аккаунтов получают доступ к данным, которые редко встречаются в сфере API: живым книгам ордеров, котировкам по конкретным моделям и истории исполненных сделок. Это превращает использование нейросетей из подписки на услугу в полноценный рыночный процесс.
Перенос биржевых механизмов на рынок инференса обнажает реальную стоимость токенов, скрытую за маркетинговыми тарифами гигантов. Однако открытая конкуренция неизбежно столкнется с проблемой нестабильной задержки, так как выбор самого дешевого узла часто идет вразрез с сетевой эффективностью. Стратегия Architect выглядит как попытка монетизировать избыточные мощности, но без прозрачной системы оценки качества ответов дешевизна может обернуться деградацией логики моделей.
Провайдеры, в свою очередь, могут выставлять котировки на продажу простаивающих ресурсов GPU, оперативно корректируя цены в зависимости от текущих операционных расходов. Регистрация новых поставщиков мощностей, по заявлениям Architect, занимает считанные минуты, а все расчеты и детализация транзакций проходят через систему Stripe.
Хотя Liquid Inference обещает значительную экономию, стоит заметить, что такие параметры, как размер платформенной комиссии и полные списки провайдеров, пока остаются закрытыми. Вероятно, это тот случай, когда за внешней простотой аукциона скрывается сложная игра арбитража, где конечному пользователю еще предстоит оценить реальное соотношение цены и качества исполнения.
Оставить комментарий