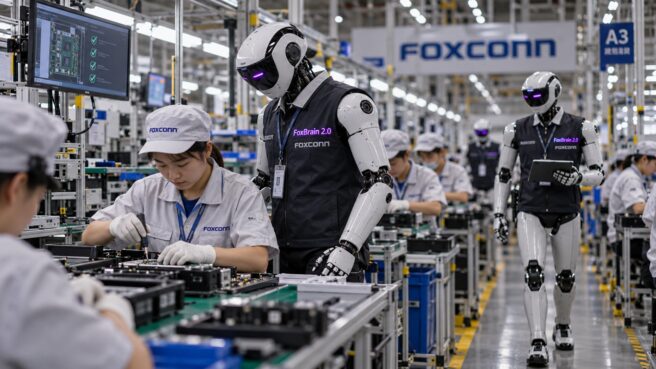
Foxconn обновляет модель FoxBrain 2.0 — теперь это инструмент для «физического ИИ»
Компания Foxconn анонсировала развитие своей ИИ-системы FoxBrain 2.0, ориентированной на мультимодальные модели для автоматизации заводов и робототехники.
Новости о технике и железе для искусственного интеллекта. GPU, TPU, специализированные AI-чипы от NVIDIA, AMD, Intel. Облачные платформы для ML, обзоры программного обеспечения, фреймворков и инструментов разработки. Аппаратное обеспечение для обучения и инференса нейросетей. Сравнения производительности и рекомендации по выбору.
Компания Foxconn анонсировала развитие своей ИИ-системы FoxBrain 2.0, ориентированной на мультимодальные модели для автоматизации заводов и робототехники.
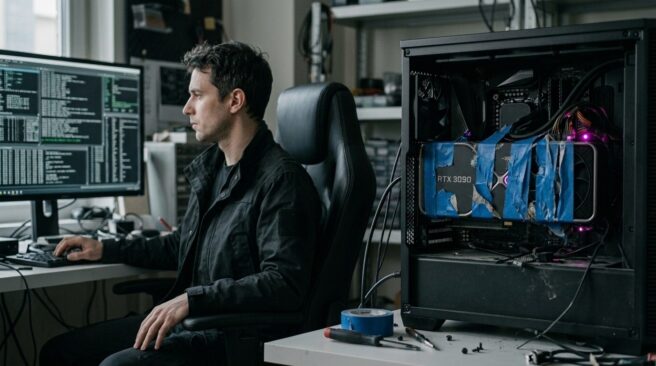
Энтузиаст смог разогнать генерацию текста на видеокарте RTX 3090 почти в пять раз, используя новые методы оптимизации инференса и спекулятивное декодирование.
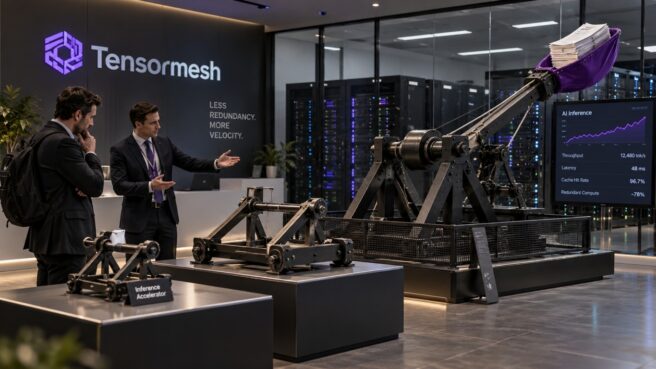
Tensormesh представила платформу для оптимизации инференса LLM через интеллектуальное управление KV-кэшем, снижая нагрузку на GPU и уменьшая задержки.
Intel анонсировала микросервисы, которые автоматически настраивают инференс больших языковых моделей под конкретное поколение процессоров Xeon через стандартный API.
Крупнейший производитель оборудования для чипов ASML признает, что не сможет удовлетворить спрос в 2027-2028 годах, несмотря на планы по расширению производства.
Architect Financial Technologies представила Liquid Inference — платформу-роутер для больших языковых моделей, работающую по принципу биржевого аукциона в реальном времени. Система позволяет провайдерам GPU конкурировать по цене за исполнение каждого запроса к API.