Architect Financial Technologies представила Liquid Inference — платформу-роутер для больших языковых моделей, работающую по принципу биржевого аукциона в реальном времени. Система позволяет провайдерам GPU конкурировать по цене за исполнение каждого запроса к API.
Проект Mesh LLM позволяет объединять мощности локальных видеокарт в распределенную сеть для запуска ИИ-моделей, предлагая альтернативу централизованным облачным сервисам.
NVIDIA представила технологию NTP, позволяющую динамически менять степень тензорного параллелизма для предотвращения простоев при обучении больших языковых моделей.
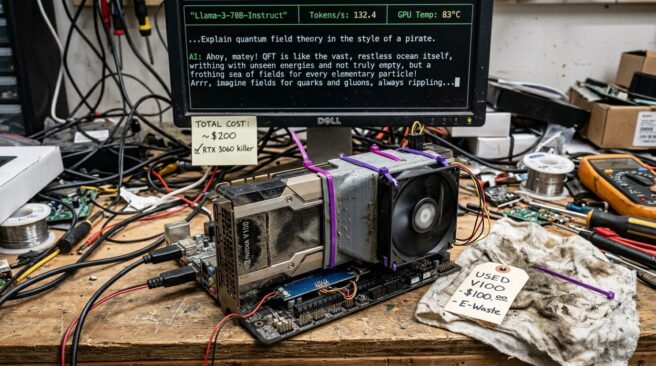
Энтузиасты адаптировали серверную NVIDIA Tesla V100 для домашнего ПК, достигнув скорости в 130 токенов в секунду, что выше показателей современных RTX 3060.
Стартап Unsloth представил кастомные ядра CUDA, которые позволяют дообучать крупные языковые модели вроде Qwen3.6-27B на обычных игровых видеокартах с 24 ГБ памяти.
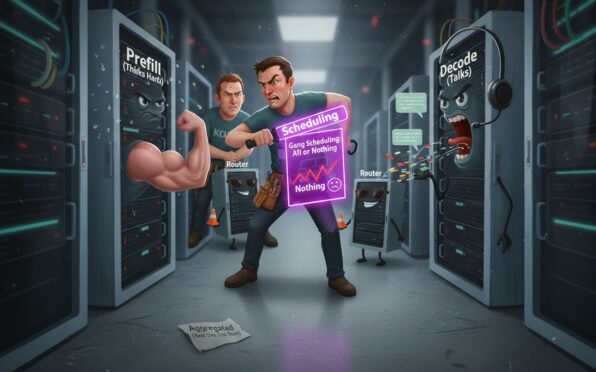
Переход от монолитного инференса к разделению стадий prefill и decode позволяет оптимизировать использование GPU, но требует сложной оркестрации в Kubernetes.