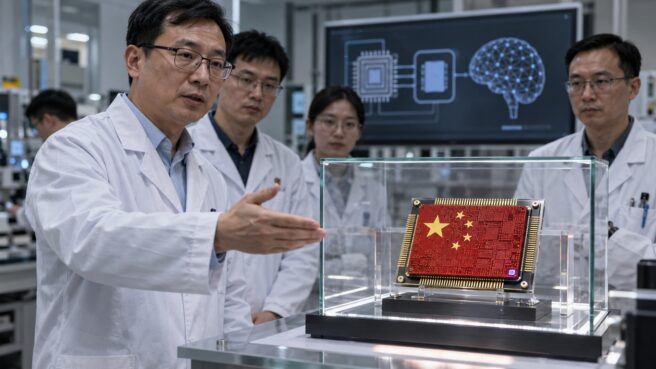

На конференции China Computing Power 2026 в Ланфане подразделение China Mobile Cloud совместно с группой технологических партнеров анонсировало архитектурное решение для работы с большими языковыми моделями, которое объединяет классические графические процессоры и нейроморфные чипы. Как пишет Pandaily, внедрение этой гетерогенной связки позволило добиться двукратного роста энергоэффективности и снижения операционных расходов на 40% при работе с моделью DeepSeek V4 Flash.
В разработке стека приняли участие ключевые игроки китайского ИТ-сектора, включая Nanhu Research Institute, компании Lynxi и Iluvatar CoreX, а также специалисты из Университета Цинхуа и Пекинского университета. Технический директор лаборатории China Mobile Cloud Ду Юйцзянь отметил, что такой подход позволяет не списывать со счетов уже развернутые парки GPU, а существенно расширять их возможности за счет добавления специализированных ускорителей.
Архитектурный маневр: разделение труда между чипами
Инженерная логика проекта строится на элегантном распределении задач внутри архитектуры Transformer. Вычисления механизмов внимания (Attention) остаются за универсальными GPU от Iluvatar CoreX, которые отлично справляются с параллельной обработкой данных. В то же время блоки Feed-forward network, особенно чувствительные к задержкам в моделях типа Mixture-of-Experts (MoE), переносятся на нейроморфное железо от Lynxi.
Нейроморфные процессоры, обладающие внушительным объемом встроенной памяти SRAM, позволяют обойти проблему «стены памяти», с которой неизбежно сталкиваются классические кластеры при высокой плотности запросов. Для синхронизации этих двух разных миров инженеры разработали собственный компилятор моделей и протокол высокоскоростного межсоединения, обеспечивающий бесшовную агрегацию результатов на этапе декодирования токенов.
Использование нейроморфных чипов для обработки блоков MoE выглядит как грамотный патч для узких мест современной архитектуры, позволяющий обойти физические ограничения стандартных GPU без перехода на дорогостоящие техпроцессы. Однако реальный успех этой затеи зависит от того, насколько универсальным окажется их проприетарный компилятор при выходе за пределы тепличных условий DeepSeek V4 Flash. Пока это выглядит как впечатляющий лабораторный рецепт, а не готовое коробочное решение для рынка.
Перспективы и практическое применение
Разработчики не планируют ограничиваться только текстовыми моделями. В планах консорциума значится адаптация стека для генерации видео, работы мультиагентных систем и обеспечения безопасности в финансовом секторе. China Mobile Cloud намерена постепенно открывать части своего фреймворка для сторонних поставщиков оборудования, формируя тем самым открытую экосистему отечественного инференса.
Несмотря на заявленные успехи в оптимизации DeepSeek V4 Flash, независимые бенчмарки системы пока отсутствуют. Для потенциальных заказчиков облачных мощностей критически важным остается вопрос, сможет ли такая сложная связка «GPU плюс нейроморф» удерживать стабильно низкую задержку под реальной нагрузкой, когда трафик выйдет за пределы демонстрационных стендов конференции. Пока это скорее многообещающий вектор развития, чем доступный к заказу артикул в прайс-листе.
Оставить комментарий