Разработчик LMCache запускает платформу для оптимизации инференса через кэширование данных
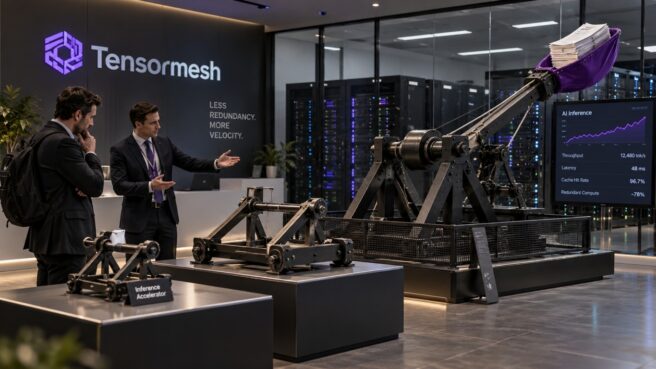
Tensormesh представила платформу для оптимизации инференса LLM через интеллектуальное управление KV-кэшем, снижая нагрузку на GPU и уменьшая задержки.
Tensormesh представила платформу для оптимизации инференса LLM через интеллектуальное управление KV-кэшем, снижая нагрузку на GPU и уменьшая задержки.
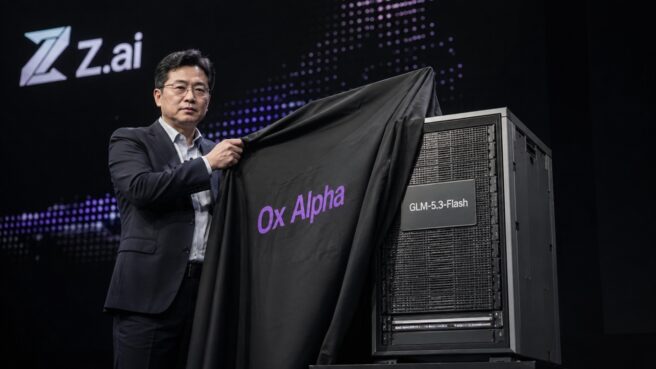
Z.ai официально выпустила GLM-5.3-Flash, ранее известную как Ox Alpha. Модель с 320 млрд параметров обещает десятикратную экономию ресурсов.
Проект компактной языковой модели на 9 миллионов параметров доказывает, что для понимания работы трансформеров не нужны миллиардные бюджеты.