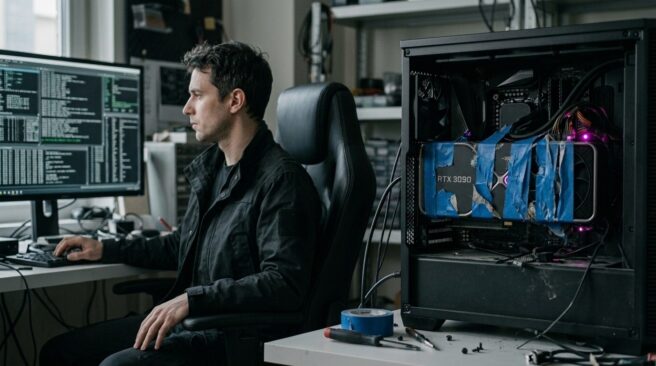

Старые графические процессоры, которые многие уже поспешили списать со счетов в эпоху стремительного развития нейросетей, неожиданно получили второе дыхание благодаря программным манипуляциям. Как сообщает издание Wccftech, разработчику под псевдонимом u/iamMess удалось увеличить скорость генерации текста на видеокарте NVIDIA RTX 3090 почти в пять раз при работе с моделью Qwen3.8-27B.
Изначально видеокарта выдавала скромные 82 токена в секунду, что для модели с 27 миллиардами параметров является типичным, но не самым впечатляющим результатом. Однако после применения кастомного движка инференса — процесса использования обученной модели для предсказания результатов — скорость подскочила до 382 токенов в секунду. Этот прорыв стал возможен не за счет разгона «железа», а путем устранения архитектурных затыков в передаче данных.
Анатомия узкого места: почему GPU простаивает
Чтобы понять суть оптимизации, стоит взглянуть на то, как именно работают большие языковые модели (LLM). Генерация текста происходит по одному токену за раз, где каждое последующее слово зависит от предыдущего. В этот момент RTX 3090 с ее 24 ГБ видеопамяти сталкивается с парадоксом: вычислительной мощности процессора предостаточно, но он вынужден ждать, пока веса модели — колоссальный объем данных — будут считаны из памяти.
Основным инструментом решения проблемы стало спекулятивное декодирование. Суть метода проста и изящна: маленькая и быстрая модель-черновик угадывает сразу несколько следующих токенов, а основная модель проверяет их все за один проход. Вместо того чтобы мучительно выверять каждое слово, система анализирует целые фразы, отбрасывая неверные варианты. При этом точность ответов не страдает, оставаясь на уровне 96,5% в математических тестах.
Этапы ускорения и практические результаты
Процесс оптимизации проходил в несколько стадий, каждая из которых добавляла системе производительности:
- Настройка встроенного механизма Multi-Token Prediction (MTP) позволила поднять скорость до 114 токенов в секунду.
- Внедрение метода DFlash2, предлагающего по семь токенов за раз, совместно с «поисковым» алгоритмом (lookup drafter), увеличило показатель до 138 токенов.
- Максимальная эффективность была достигнута при работе с документами: движок научился проверять до 16 токенов за шаг, достигнув пиковых 382 токенов в секунду.
Методика спекулятивного декодирования эффективно маскирует задержки памяти, превращая RTX 3090 из ‘узкого горлышка’ в производительный узел. Однако стоит помнить, что четырехкратный прирост наблюдается в основном при цитировании готовых текстов, тогда как в обычном чате скорость скромнее — около 133 токенов. Это впечатляющий инженерный хак, который, тем не менее, требует значительных ресурсов контекстного окна и вдвое замедляет первичную загрузку данных. Перед нами классический пример победы алгоритмов над грубой силой, имеющий свою цену в виде усложнения архитектуры.
Помимо скорости, разработчик смог расширить окно контекста до 138 696 токенов, используя более компактный формат хранения рабочей памяти. Это открывает двери для анализа огромных массивов данных на домашнем оборудовании, хотя и требует компромиссов: расширенная проверка занимает дополнительные слоты запросов. Важно отметить, что данные результаты пока не получили независимого подтверждения, поэтому к ним стоит относиться с долей здорового скептицизма.
Оставить комментарий