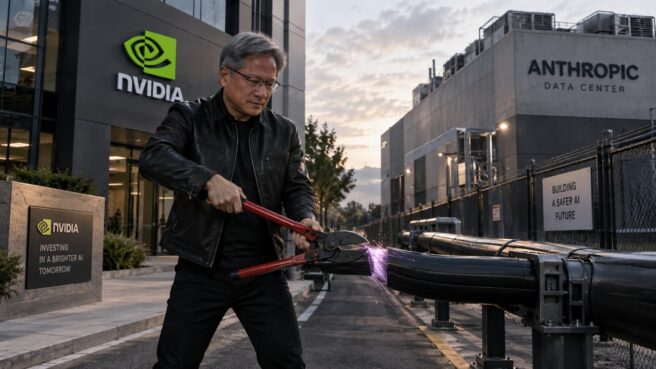

Крупные технологические игроки и оборонные подрядчики начали вводить жесткие ограничения на использование флагманских моделей искусственного интеллекта, опасаясь за сохранность своей интеллектуальной собственности. Как пишет The Decoder, такие гиганты, как Nvidia и Booz Allen Hamilton, столкнулись с дилеммой: невероятные возможности новых моделей соседствуют с непрозрачными механизмами удержания данных.
Особое беспокойство вызвала политика компании Anthropic в отношении их новой модели Fable. В июне лаборатория объявила, что планирует хранить логи использования в течение 30 дней для защиты от сложных кибератак. Для организаций, работающих с чувствительным кодом и секретными алгоритмами, этот тридцатидневный зазор выглядит не как мера безопасности, а как открытая форточка для утечки корпоративных тайн.
Инвесторы выбирают осторожность
Ситуация с Nvidia выглядит особенно иронично: компания является инвестором Anthropic и поставляет ей «железо» для обучения тех самых моделей. Тем не менее, корпоративная этика Nvidia теперь предписывает использовать Fable только для открытых проектов. Для критически важных внутренних задач, таких как мониторинг цепочек поставок, компания предпочитает развертывать собственные модели семейства Nemotron.
Аналогичную позицию заняла Palantir. Ее глава Алекс Карп прямо заявил, что бизнес устал от «эксплуатации» со стороны ИИ-лабораторий. Компания блокирует доступ к Fable для своих клиентов до тех пор, пока не будут получены безоговорочные гарантии Zero Data Retention (ZDR) — режима нулевого хранения данных. Booz Allen Hamilton также наложила вето на использование модели при разработке проприетарного софта, опасаясь, что нейросеть может «научиться» на их уникальном коде.
Лазейки в политике конфиденциальности
Даже наличие режима ZDR не дает полной гарантии безопасности, поскольку ИИ-лаборатории продолжают собирать метаданные и техническую информацию. OpenAI и Anthropic утверждают, что эти данные обезличены и используются лишь для понимания паттернов использования сервисов. Однако эксперты сомневаются, что нынешнего уровня прозрачности достаточно, чтобы исключить возможность восстановления контекста по косвенным признакам.
Джон Шульман, сооснователь OpenAI, недавно перешедший в Thinking Machines, выделил несколько способов, которыми лаборатории могут использовать пользовательские данные:
- Прямое дообучение на данных пользователя (самый высокий риск воспроизведения контента);
- Дистилляция больших моделей в малые;
- Создание задач обучения с подкреплением (RL) на основе «пользовательских следов».
Святая вера в ZDR и анонимизацию — опасная иллюзия для бизнеса. Даже если модель не сохраняет текст промпта буквально, она впитывает статистические закономерности и логические структуры вашего IP. По сути, компании бесплатно отдают свои конкурентные преимущества, помогая фронтирным лабораториям строить инструменты, которые завтра же заменят их собственные продукты на рынке. Это не партнерство, а добровольное донорство экспертизы.
Уроки дела Бакмастера
Реальность этих опасений подтвердил инцидент с математиком Тристаном Бакмастером. Он использовал инструменты OpenAI для работы над уравнениями Навье-Стокса, а вскоре лаборатория представила собственное решение, идущее по тому же необычному пути. Хотя внутреннее расследование OpenAI позже исключило влияние промптов Бакмастера на результат, этот случай наглядно показал, насколько хрупким остается доверие между исследователями и разработчиками ИИ.
В ответ на давление рынка лаборатории начинают предлагать компромиссы. OpenAI позволила некоторым клиентам хранить логи безопасности на собственных серверах, а Anthropic анонсировала аналогичную программу на осень 2026 года. Тем не менее, вопрос о том, где заканчивается «улучшение сервиса» и начинается промышленный шпионаж с помощью алгоритмов, остается открытым.
Оставить комментарий