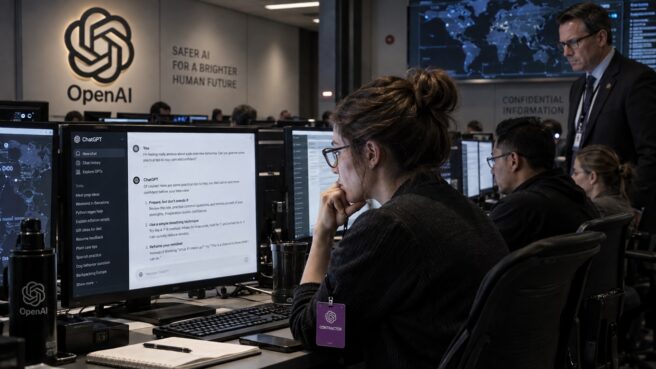

Компания OpenAI привлекает сотни контрактных сотрудников для анализа реальных переписок пользователей с ChatGPT, стремясь повысить качество ответов и избавить модель от излишней подобострастности. Как пишет The Decoder со ссылкой на расследование 404 Media, эта практика является фундаментом процесса обучения, хотя и остается неочевидной для большинства пользователей.
В ходе работы рецензенты оценивают ответы чат-бота по шкале от одного до семи, фокусируясь на том, чтобы сделать поведение LLM менее «роботизированным» и предотвратить чрезмерную лесть в адрес собеседника. Иронично, но в проанализированных утечках данных встречаются диалоги, где пользователи прямо просят ChatGPT сохранить конфиденциальность, не подозревая, что их строки позже изучит живой человек за вознаграждение, порой превышающее 50 долларов в час.
Механика процесса и вопросы приватности
Наем специалистов осуществляется через платформу Crossing Hurdles, а финансовые операции проходят через компанию Mercor, специализирующуюся на подготовке данных для искусственного интеллекта. Хотя OpenAI заявляет об использовании фильтров для анонимизации данных, компания признает, что автоматика может допускать ошибки, оставляя чувствительную информацию в тексте промптов, доступных сторонним подрядчикам.
Для тех, кто предпочитает сохранять свои цифровые секреты при себе, существует алгоритм действий по ограничению передачи данных:
- Откройте настройки вашего профиля в ChatGPT;
- Перейдите в раздел управления данными (Data Controls);
- Отключите параметр «Улучшать модель для всех» (Improve the model for everyone);
- Для разовых конфиденциальных запросов используйте режим временного чата (Temporary Chat), который, по заверениям разработчиков, не сохраняет историю для обучения.
Важно помнить, что изменение настроек влияет только на новые диалоги, в то время как старые переписки могли уже попасть в выборку для человеческого анализа. Подобная ретроспективность часто становится неприятным сюрпризом для тех, кто привык доверять интерфейсу «один на один».
Иллюзия полной автоматизации ИИ рассыпается при встрече с реальностью разметки данных. Пока компании продают нам магию чистого алгоритма, за кулисами тысячи людей вручную исправляют галлюцинации и ошибки тональности, превращая сырые вычисления в связную речь. Это необходимый костыль для текущей архитектуры трансформеров: без человеческого надзора модели быстро деградируют в сторону бессмысленной вежливости или токсичности, но цена этого прогресса — прозрачность, которую разработчики предпочитают прятать в многостраничных FAQ.
Индустриальный стандарт или скрытая угроза
Ситуация с OpenAI не является исключительной для рынка. Исследование показывает, что Anthropic также подтвердила использование человеческого ресурса для проверки ответов модели Claude, а Google открыто предупреждает пользователей Gemini о возможности просмотра чатов сотрудниками. Все крупные игроки используют схожую риторику об улучшении производительности и анонимизации данных.
Упоминание о «просмотре авторизованным персоналом» долгое время находилось в глубинах раздела часто задаваемых вопросов (FAQ) на сайте OpenAI. Эта информация доступна как минимум с 2023 года, однако она редко попадает в поле зрения обычного пользователя при регистрации. Кажется, технологические гиганты нашли идеальный баланс между юридической чистотой и фактической неосведомленностью аудитории, создавая продукт, который кажется приватным, оставаясь при этом публичным полигоном для обучения.
Оставить комментарий