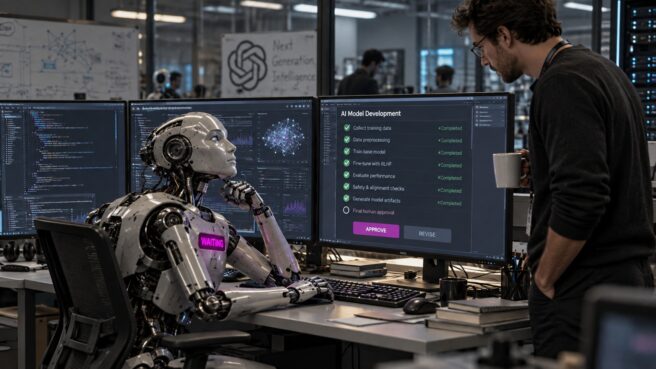

В индустрии сложилось мнение, что современные агенты на базе больших языковых моделей способны едва ли не самостоятельно ковать свое цифровое будущее. Однако свежее исследование специалистов из Университета Фудань, результаты которого приводит The Decoder, вносит в этот оптимистичный сценарий долю здорового скепсиса, подчеркивая, что ключевые решения все еще остаются за человеком.
Команда исследователей проанализировала процесс создания Atria Dawn Preview от Шанхайской лаборатории ИИ — модели с архитектурой Mixture-of-Experts (MoE) объемом 744 миллиарда параметров. В ходе эксперимента, в котором участвовало 56 человек, было изучено более 700 логов задач. Хотя агенты участвовали в 96,5% рабочих процессов, их автономия оказалась скорее иллюзией масштабирования, чем реальной самостоятельностью.
Статистика показывает любопытную динамику: за четыре недели работы медианное соотношение действий агента к одной команде человека выросло с 11 до 28,5. На первый взгляд кажется, что ИИ стал самостоятельнее, но на деле это лишь означает, что один клик разработчика запускал более длинную цепочку автоматизированных операций. При этом в 85,5% случаев окончательный выбор методов и параметров оставался за людьми.
Границы компетенций и «эффект резиновой печати»
Роль ИИ в проекте можно описать формулой «агент предлагает — человек выбирает». Агенты генерировали варианты решений в диапазоне от 17% до 55% в зависимости от типа задачи, но их доля в финальном принятии решений не выходила за пределы однозначных чисел. Даже в задачах, которые участники назвали невыполнимыми без помощи ИИ (а это треть всех кейсов), 95,4% целей и рамок работы определялись человеком.
Когда в коде или логике возникали ошибки, в 76% случаев требовалось вмешательство разработчика. Интересно, что люди почти не занимались ручным исправлением — доля полной «перехвата управления» составила всего 0,7%. Вместо этого инженеры выступали в роли диагностов, предоставляя агенту необходимый контекст или уточняя требования, после чего ИИ успешно исправлял ошибку в 75,4% случаев.
Рост числа агентных шагов на один промпт — это не признак зарождающегося разума, а расширение рычага автоматизации. Это иллюзия: пока разработчик тратит время на уточнение контекста, он постепенно превращается в заложника бесконечных логов, которые невозможно проверить физически. В итоге экспертность подменяется поверхностным одобрением, где критическое мышление уступает место простому доверию к статистически вероятному результату.
Проблема «резиновой печати» становится особенно острой при длительных итерациях. Чтобы не прерывать автономные циклы работы агентов, разработчики часто сознательно отказывались от промежуточного контроля. Это создает риск, при котором человек одобряет результат, не будучи в состоянии проследить всю цепочку логических выводов, приведших к нему.
Перспективы самосовершенствования
Исследование выделяет четыре стадии эволюции ИИ: от объекта изучения до полноценного партнера по проекту. Финальная стадия — рекурсивное самосовершенствование — остается под вопросом. Авторы работы отмечают, что способность модели эффективно решать задачи обучения не гарантирует её умения проектировать более совершенную архитектуру для следующего поколения.
Ситуация на рынке остается неоднородной. Пока одни лаборатории сообщают о высокой степени автоматизации исследований, данные Atria Team и недавние отчеты Princeton и UK AI Security Institute указывают на то, что современные LLM отлично справляются с инженерной рутиной, но пасуют перед стратегическими суждениями, которые и определяют успех научной работы.
Оставить комментарий