
Оглавление
В мире искусственного интеллекта произошло событие, которое заставляет по-новому взглянуть на возможности больших языковых моделей в фундаментальной науке. Группа из 35 исследователей, представляющая такие институты, как Harvard University, ICTS и Google DeepMind, представила новый бенчмарк TheoPhysEval, состоящий из 50 уникальных задач по теоретической физике. Как сообщает издание The Decoder, модель GPT-6-Astra от OpenAI продемонстрировала феноменальный результат, правильно решив 49 из 50 предложенных задач.
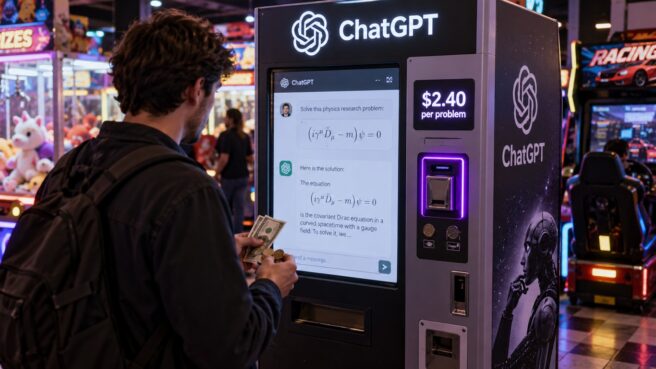
Стоимость такого «интеллектуального штурма» оказалась на удивление низкой: в среднем решение одной задачи обходилось в 2,40 доллара, а прохождение всего теста стоило чуть менее 116 долларов. Для сравнения, профильному специалисту на решение одной подобной задачи без помощи ИИ потребовался бы целый рабочий день, а эксперту из смежной области — значительно больше времени. Это подчеркивает не только точность, но и колоссальную экономическую эффективность современных агентов.
Рутина против прорывов: что именно тестировали ученые
Авторы бенчмарка сознательно избегали «великих проблем тысячелетия», сосредоточившись на так называемых задачах «прокрутки механизма». Это сложные вычисления, требующие адаптации известных методов к новым условиям — работа, которую обычно поручают аспирантам на старте их научной карьеры. Например, одна из задач требовала пересчитать уравнения черных дыр, перенеся их из пятимерного пространства в четырехмерное, что потребовало бы от человека написания кастомного кода и нескольких дней кропотливого труда.
В тестировании участвовал целый ряд моделей, и результаты распределились следующим образом:
- GPT-6-Astra (OpenAI) — 98% успеха;
- Opus 5.5 (Anthropic) — 92% успеха;
- Gemini 3.8 Flash (Google) — 68% успеха;
- DeepSeek-V4.1-Flash — 54% успеха.
Интересно, что наличие доступа к интернету почти не повлияло на результаты топовых моделей. GPT-6-Astra и Opus 5.5 сохранили точность на уровне 92% даже в изоляции. Это наводит на мысль, что современные LLM фактически «заучили» огромные пласты научной литературы, удерживая в своих весах сложнейшие формулы, которые даже эксперты привыкли подсматривать в справочниках.
Способность ИИ решать сложнейшие уравнения за гроши впечатляет, но не стоит путать вычислительную мощность с научным прозрением. Мы видим идеальный «калькулятор смыслов», который безупречно оперирует готовыми концепциями, но все еще пасует перед необходимостью задавать правильные вопросы. Пока нейросети лишены научного «вкуса», они остаются лишь элитными исполнителями, превращающими теоретическую физику в соревнование бюджетов на токены, а не в битву идей.
Отсутствие «вкуса» как главный барьер для ИИ
Несмотря на доминирование в вычислениях, ИИ пока не совершил в физике прорыва, сопоставимого с недавними успехами в математике, где агенты уже помогают решать фундаментальные уравнения Навье-Стокса. Исследователи объясняют это отсутствием у моделей интеллектуального «вкуса» — способности интуитивно определять, какая задача является по-настоящему интересной и перспективной, а какая — лишь нагромождением скучных деталей.
Процесс реального исследования редко бывает линейным. Когда ученый сталкивается с непреодолимым препятствием, он переформулирует вопрос или переключается на смежную, более простую, но не менее важную проблему. Текущие ИИ-агенты, при всей их мощи, склонны слепо следовать заданному алгоритму, не обладая гибкостью человеческого мышления. Впрочем, авторы отчета подчеркивают, что это лишь текущее положение дел, а не окончательный приговор для автономных систем в науке.
Развитие подобных инструментов ставит перед академическим сообществом и этические вопросы. Теоретическая физика всегда считалась «дешевой» дисциплиной, где для успеха требовались лишь бумага, карандаш и острый ум. Теперь же результат может начать зависеть от вычислительных ресурсов и бюджета группы. В мире, где GPT-6-Astra берет на себя рутину, физикам, возможно, придется меньше считать и гораздо больше думать о самой сути явлений.
Оставить комментарий