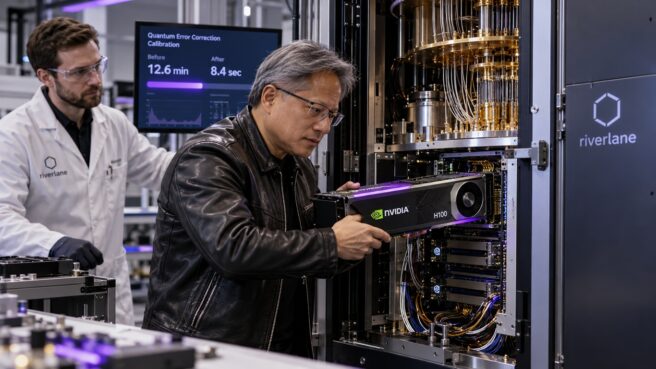

Разработчик технологий квантовой коррекции ошибок Riverlane и технологический гигант NVIDIA представили результаты совместного исследования, подтверждающие значительное ускорение калибровки декодеров в квантовых системах при использовании графических процессоров. Согласно отчету Quantum Computing Report, применение ИИ-циклов на базе GPU позволяет автоматизировать процесс настройки, который ранее требовал значительных временных затрат.
В основе любой системы исправления ошибок лежит декодер, который опирается на численные веса, отражающие вероятность сбоев в аппаратной части. Проблема заключается в том, что физические кубиты подвержены дрейфу параметров: частоты смещаются, дефекты активируются, а точность логических вентилей падает. Из-за этой нестабильности настройки декодера быстро устаревают, что вынуждает инженеров проводить повторную калибровку между запусками экспериментов.
Для решения этой задачи партнеры адаптировали алгоритм Local Clustering Decoder (LCD) от Riverlane для работы с высокопроизводительными GPU. Протокол оптимизации, вдохновленный наработками Google Quantum AI, позволяет оценивать веса декодера напрямую на основе экспериментальных данных, используя параллельные вычисления для обработки огромных массивов информации о синдромах ошибок.
Сравнение производительности: CPU против GPU
Результаты тестирования показывают качественный скачок в скорости обработки данных. Использование NVIDIA H100 позволяет сократить время одной эпохи обучения для поверхностного кода с трех минут до нескольких секунд. Это критически важно для систем, где дрейф параметров происходит быстрее, чем завершается классический цикл калибровки на центральных процессорах.
| Метрика производительности | Одноядерный CPU | NVIDIA H100 GPU | Фактор ускорения |
|---|---|---|---|
| Эпоха (Surface Code) | ~180 секунд | 2.8 секунды | в 65 раз быстрее |
| Пропускная способность | ~59 000 синдромов/сек | > 4 200 000 синдромов/сек | в 71 раз выше |
| Пропускная способность (Repetition Code) | Базовый уровень | ~155 000 000 синдромов/сек | в 121 раз выше |
Интересно заметить, что даже мощная конфигурация с 32-ядерным CPU уступает одному графическому ускорителю H100 почти в три раза. Параллельная архитектура GPU идеально подходит для пакетной обработки синдромов, что в конечном итоге позволило снизить частоту логических ошибок в два раза по сравнению с базовыми, некалиброванными настройками.
Перенос калибровки на GPU выглядит как логичный шаг, но он лишь подчеркивает фундаментальную слабость нынешних кубитов — их патологическую нестабильность. Мы строим сложнейшие вычислительные надстройки просто для того, чтобы железо не ‘забывало’, как работать, каждые несколько минут. Пока индустрия празднует кратный рост пропускной способности, реальный вызов остается в плоскости материаловедения, а не в умении NVIDIA быстро перемножать матрицы.
В текущем технологическом стеке формируется разделение обязанностей: GPU берут на себя задачи офлайн-обучения и оптимизации, в то время как специализированные системы, такие как Deltaflow от Riverlane, обеспечивают декодирование в реальном времени с минимальной задержкой. Эта гибридная архитектура становится стандартом для управления современными квантовыми процессорами, где классические вычисления выступают в роли необходимого «костыля» для поддержания жизнеспособности квантовых операций.
Оставить комментарий