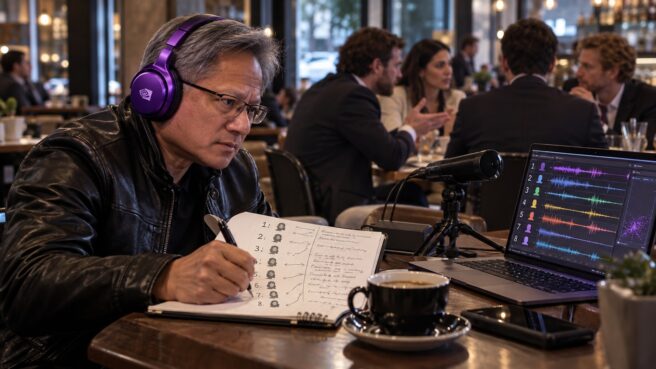

Компания Nvidia выпустила в открытый доступ Nemotron 3 Diarization — специализированную модель искусственного интеллекта, предназначенную для идентификации участников беседы. Как сообщает The Decoder, архитектура с 100 миллионами параметров способна различать до восьми спикеров одновременно, работая как с предварительными записями, так и с потоковым аудио в режиме реального времени.
Технология диаризации — это, по сути, ответ системы на вопрос «кто и когда говорил». Nemotron 3 справляется с этой задачей, даже если собеседники перебивают друг друга, хотя точность ожидаемо снижается при сильном фоновом шуме или избыточной реверберации помещения. Веса модели уже опубликованы на платформе Hugging Face, что делает инструмент доступным для интеграции в сторонние сервисы транскрибации.
Технические характеристики и производительность
В основе решения лежит гибкая настройка аудио-буфера: разработчики могут выбирать из четырех уровней задержки — от 30,4 до 0,32 секунды. Стоит учитывать, что погоня за минимальным пингом в данном случае неизбежно бьет по качеству распознавания. Тем не менее, в бенчмарке VoiceArena Diarization v1 модель показала впечатляющий результат, заняв первое место с показателем ошибки (DER) в 14,7%.
Если сравнивать новинку с предыдущим решением компании — Streaming Sortformer, то прогресс выглядит вполне осязаемым. При использовании буфера в 1,04 секунды средний уровень ошибок снизился на 41%. Система не просто «слышит» голоса, но и фиксирует тончайшие моменты переходов между спикерами, что критично для создания читаемых протоколов встреч.
Компактность в 100 миллионов параметров делает Nemotron 3 эффективным инструментом для локального развертывания, избавляя от задержек облачного инференса. Однако лидерство в бенчмарках не должно вводить в заблуждение: DER на уровне 14% в стерильных условиях VoiceArena может легко превратиться в кашу при записи на плохой микрофон в кафе. Nvidia создала отличный строительный блок, но для полноценного продукта его все еще нужно подпирать мощным движком распознавания речи и качественной постобработкой.
Для получения полноценного текстового протокола с именами Nemotron 3 Diarization необходимо использовать в связке с системами автоматического распознавания речи (ASR), такими как Parakeet. В такой конфигурации на выходе получается текст, где реплики размечены тегами вроде «speaker_1» или «speaker_2». Учитывая открытость весов, можно предположить, что вскоре мы увидим это решение во многих корпоративных мессенджерах и сервисах видеосвязи.
Интересно наблюдать, как фокус смещается в сторону небольших, узкоспециализированных моделей. Вместо того чтобы пытаться научить одну нейросеть «всему на свете», инженеры предлагают эффективный модульный подход. И хотя анонимные метки спикеров пока не заменяют полноценную идентификацию по именам, для автоматизации офисной рутины этого вполне достаточно, если, конечно, вы не боитесь доверить свои разговоры алгоритмам.
Оставить комментарий