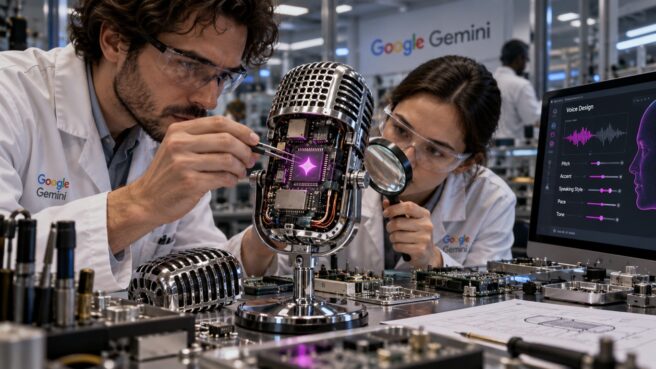

Компания Google анонсировала выпуск двух новых моделей синтеза речи — Gemini 3.8 Flash TTS и Flash-Lite TTS. Как сообщает The Decoder, инструменты поддерживают более 100 языков и позволяют создавать уникальные голосовые профили на основе текстовых промптов или коротких аудиосемплов.
Старшая модель, Flash TTS, ориентирована на творческие задачи: озвучивание подкастов, создание персонажей для видеоигр и аудиокниг. Версия Flash-Lite TTS оптимизирована для масштабных и бюджетных сценариев, таких как дубляж видеоконтента и работа голосовых ассистентов, где важна скорость и низкая стоимость генерации.
Управление голосом через текст и инструкции
Одной из наиболее любопытных функций стала возможность проектирования голоса «с нуля». Пользователь может описать роль, акцент и вокальные характеристики персонажа в текстовом виде, а модель воплотит это в звуке. Для тех, кто предпочитает готовые решения, Google подготовила библиотеку из 2 000 пресетов, включающую редкие региональные диалекты, такие как квебекский французский или шотландский английский.
Разработчики также внедрили поддержку сценарных указаний. Теперь в скрипт можно добавлять маркеры для невербальных звуков — смеха, вздохов или характерных пауз. Система способна работать в режиме диалога двух разных персонажей, сохраняя их индивидуальные черты на протяжении длительного времени без заметного искажения тембра, известного как «дрейф спикера».
Внедрение эмоциональных маркеров и текстового дизайна голоса — это серьезный шаг к демократизации качественного аудиоконтента. Однако фоновый шум и нестабильность тембра в сложных сценариях напоминают, что перед нами все еще сырой инструмент. Google мастерски упаковывает возможности, но пока модели не избавятся от артефактов на стыках фраз, их применение в профессиональном продакшене останется под вопросом. Технологический триумф здесь соседствует с операционной недосказанностью: мы получаем мощный молоток, который иногда бьет мимо гвоздя.
Доступность и экономика использования
Интеграция новых моделей уже началась через Gemini API и Google AI Studio. Flash TTS также появилась в Gemini Notebook, а облегченная версия доступна в Google Vids. Стоит отметить, что такие платформы, как Agora, LiveKit и Vercel, уже подтвердили поддержку новых инструментов от Google.
Вопрос стоимости традиционно разделен на этапы. До конца 2026 года действуют льготные тарифы:
- Flash TTS: около $0,81 за час готового аудио (90 000 аудиотокенов).
- Flash-Lite TTS: примерно $0,54 за час генерации.
- С 1 января 2027 года цены на вывод аудио вырастут вдвое, достигнув $1,62 и $1,08 соответственно.
Важным нюансом остается конфиденциальность: данные пользователей бесплатного уровня используются для обучения моделей Google, в то время как платный уровень гарантирует изоляцию информации. Несмотря на впечатляющие тесты в бенчмарках, независимые проверки фиксируют периодические высокочастотные шумы, что намекает на необходимость дальнейшей полировки алгоритмов перед полноценным внедрением в Enterprise-сегмент.
Оставить комментарий