
Оглавление
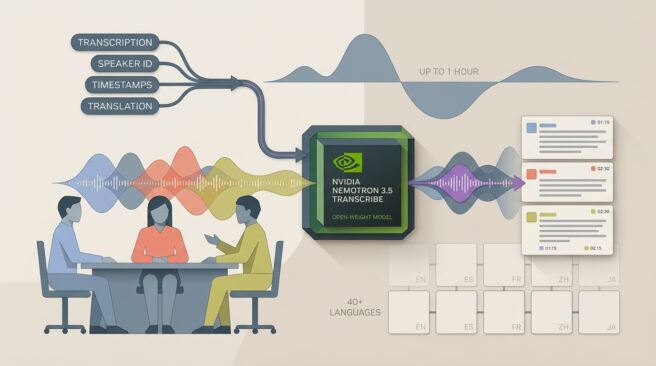
NVIDIA выпустила Nemotron 3.5 Transcribe — открытую модель для работы с речью, которая принимает аудио длительностью до часа и поддерживает 40 языков. По данным MarkTechPost, она может выдавать дословную или отредактированную расшифровку, отмечать говорящих, ставить временные метки, учитывать контекст и переводить речь.
В одной системе объединены функции, для которых разработчикам обычно нужны отдельные инструменты распознавания речи, разделения реплик по говорящим и выравнивания текста с аудио. Модель относится к классу речевых языковых моделей (SALM): аудио сначала обрабатывает специальный кодировщик, а языковая модель превращает его представление и текстовую инструкцию в результат.
Архитектура и обучение
В модели три основных компонента. Первый — параллельный экспертный кодировщик: обучаемый трансформер для распознавания речи на 0,6 млрд параметров работает рядом с замороженной моделью Nemotron 3 Diarization. Диаризация — это определение того, кто и когда говорит; система отслеживает до восьми собеседников. Данные об активности говорящих добавляются к признакам распознавания каждые 80 миллисекунд.
Второй компонент — языковая основа Nemotron 3.5 Lightning 30B-A3B, гибридная модель Mamba-Transformer с разреженной смесью экспертов (MoE). Всего в ней 52 слоя: 23 Mamba-2, 23 слоя MoE и шесть слоёв внимания. В каждом слое MoE выбираются шесть из 128 экспертов и один общий эксперт. Небольшое число слоёв внимания помогает экономить память KV-кэша при обработке длинных аудиозаписей.
Третий компонент — слой предсказания нескольких токенов, который предлагает варианты продолжения для ускоренного декодирования, и адаптер CTC на 50 млн параметров. Последний сопоставляет готовый текст с аудио и позволяет получать временные метки отдельных слов.
Название указывает на конфигурацию 30B-A4B, но контрольная точка содержит около 34 млрд параметров. Разница связана с модулем предсказания на 1,3 млрд параметров и аудиокомпонентами. Обучение включало один этап контролируемой тонкой настройки на 256 видеокартах H100 в течение 28 500 шагов, а затем короткий этап обучения с подкреплением: 400 обновлений GSPO с наградой, равной единице минус WER.
WER — доля ошибок в словах по сравнению с эталонной расшифровкой; чем она ниже, тем точнее результат. По данным NVIDIA, модель обучалась на 1,72 млн уникальных часов аудио, или на 6,5 млн часов с учётом повторов.
Результаты и ограничения
В техническом отчёте NVIDIA модель получила среднюю WER 4,71% на девяти открытых англоязычных наборах данных. Среди открытых моделей следующий результат у Qwen3-ASR-1.7B — 4,94%. Семь коммерческих систем показали более низкую ошибку; лучший результат в этом сравнении у OtterAI speech-v3.1 — 3,88%.
На открытом многоязычном тесте по семи языкам средняя WER составила 4,62%, против 6,49% у Qwen3-ASR-1.7B. ElevenLabs Scribe v2 показала 3,56%. На длинных записях результат Nemotron — 10,98%, тогда как у Parakeet-TDT-0.6B-v3 — 13,37%.
В тестах с несколькими говорящими на полных записях модель получила среднюю cpWER 15,80%. Эта метрика учитывает ошибки слов после сопоставления реплик с говорящими. У DiCoW v3.3 с DiariZen результат составил 16,83%. NVIDIA называет Nemotron первой речевой языковой моделью, обошедшей каскадные системы в этом сравнении.
Контекстный список названий и терминов заметно помог распознаванию имён и других сущностей: ошибка WER на ContextASR-Bench снизилась с 12,21% до 2,20%. Но качество зависит от типа записи и языка. На удалённых совещаниях на китайском языке модель показала 34,95% cpCER — показатель ошибок на уровне символов. NVIDIA также указывает на слабые результаты при переключении между языками в одной записи.
Сильная сторона Nemotron — не только точность распознавания, но и объединение расшифровки, разметки говорящих и временных меток в одной открытой модели. Это упрощает сборку локальных систем, однако крупные требования к памяти и слабые результаты на китайских совещаниях напоминают: универсальность в списке функций ещё не означает одинакового качества для каждой задачи.
Развёртывание и производительность
Вариант BF16 рассчитан на одну H100 с 80 ГБ памяти. Также доступны контрольные точки FP8 примерно на 35 ГБ и NVFP4 примерно на 21 ГБ; вариант NVFP4 запускается на RTX 5090. Файлы GGUF предназначены для NeMo-Speech.cpp. Опционально можно использовать черновую модель DFlash2.
Для запуска подходят vLLM 0.32.0 с плагином NeMo Speech, Transformers и SGLang-Omni 0.2.0. В vLLM доступен интерфейс, совместимый с API OpenAI. NVIDIA оценивает скорость на одной H100 в BF16 с MTP2 примерно в 410 раз быстрее длительности аудио (RTFx).
Отдельная инфраструктура Nemotron Transcribe NIM показывает более высокие цифры: с NVFP4 и DFlash2 одна RTX PRO 6000 Blackwell Server Edition обрабатывает 2 238 секунд аудио за секунду, а 30-секундный фрагмент — за 0,13 секунды. Однако оптимизации обслуживания модели пока не открыты. NVIDIA ожидает, что доступный при выпуске путь через vLLM будет примерно вдвое медленнее.
Компания также проверила 17 задач для тонкой настройки. Каждая занимала от 0,5 до 2,3 часа работы одного графического ускорителя GB300. Модель распространяется по лицензии OpenMDW-1.1, допускающей коммерческое использование.
Сравнение с другими открытыми моделями
| Характеристика | Nemotron 3.5 Transcribe | Qwen3-ASR-1.7B | Canary-Qwen-2.5B | Whisper-large-v3 |
|---|---|---|---|---|
| Параметры | 34 млрд всего, около 4,3 млрд активных | 1,7 млрд | 2,5 млрд | 1,55 млрд |
| Языки | 40 | 30 языков и 22 китайских диалекта | Только английский | 99 по метке Hugging Face |
| Максимальная длительность аудио | 1 час | Не указана | 40 секунд в обучении | Окно 30 секунд, длинные записи — частями |
| Определение говорящих | Встроено, до 8 человек | Не заявлено | Не заявлено | Не заявлено |
| Временные метки слов | Встроены, через CTC-адаптер | Через отдельный ForcedAligner-0.6B | Не заявлены | Есть |
| Лицензия | OpenMDW-1.1 | Apache-2.0 | CC-BY-4.0 | Apache-2.0 |
| Средняя WER на девяти открытых англоязычных наборах | 4,71% | 4,94%* | 5,38%* | 6,66%* |
| Средняя WER на собственных карточках моделей, более ранний набор тестов | Не указана | 5,76% | 5,63% | 7,44% |
| Средняя WER на многоязычном тесте по семи языкам | 4,62% | 6,49%* | Не применимо | 7,94%* |
| Оборудование для ориентира | Одна H100 80 ГБ в BF16 | Не указано | Проверялась на A6000, A100 и RTX 5090 | Не указано |
* Оценки конкурентов на текущем наборе из девяти тестов приведены в отчёте NVIDIA со ссылкой на данные рейтинга Hugging Face за октябрь 2026 года. Состав рейтинга менялся, поэтому эти значения нельзя напрямую сопоставлять с более ранними результатами на карточках самих моделей.
Итог NVIDIA — открытая модель, которая объединяет несколько этапов обработки речи и показывает лучший результат среди открытых систем на приведённых англоязычном и многоязычном тестах. Коммерческие API пока впереди, а для локального запуска нужны мощные ускорители; отдельные сценарии, включая китайские совещания, остаются заметно более трудными.
Оставить комментарий