
Оглавление
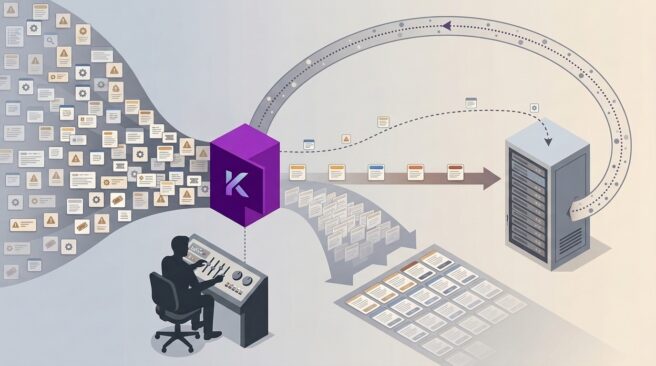
Компания Kindo представила Deep Hat Sift — ИИ-модель, которая отбирает события из потоков оповещений, заявок и журналов и решает, какие из них отправлять большой языковой модели (LLM), а какие можно пропустить. Так компания предлагает сократить расходы на обработку событий без отказа от ИИ-агентов на самых загруженных источниках, сообщает VMblog.
До появления Sift у предприятий, по описанию Kindo, был не слишком удобный выбор: поручить LLM проверку каждого события и платить за это либо вовсе не подключать ИИ-агентов к источникам с большим потоком данных. Sift должен убрать эту развилку: агент получает события, где действительно есть работа, а каждое отфильтрованное событие не требует обработки большой моделью.
Как устроена фильтрация
Deep Hat Sift относится к классу моделей, который компания называет System One: это быстрые и недорогие системы, принимающие решение «да или нет», а не генерирующие текст. Простые фильтры существовали и раньше, но, как отмечает Kindo, им трудно доверить решение о том, что именно можно пропустить. Модели с фиксированными весами отражают состояние на момент выпуска; для улучшения их приходится заново обучать и выпускать.
Sift учится на решениях обслуживаемого им агента: по его вердиктам модель постепенно определяет, какие события агент счёл бы значимыми. Переобучение сторонней модели и отдельный проект по разметке данных не нужны. Предполагается, что с накоплением решений Sift точнее отбирает события для конкретного агента.
Система сначала работает в теневом режиме: оценивает каждое событие, но пока передаёт агенту весь поток. Так она сопоставляет собственные оценки с вердиктами агента — в частности, выясняет, какие события тот отклоняет. Затем Sift показывает клиенту на его собственных данных, что именно модель отфильтровала бы. Фильтрация начинается только после того, как человек утвердит порог и письменно укажет причину.
Даже после этого случайная выборка событий, которые Sift собирался бы удержать, продолжает поступать агенту. Это позволяет постоянно измерять долю пропусков. По словам инженера Deep Hat Sift Троя Пресли, если качество модели ухудшается, система должна перейти в отказобезопасный режим: пропускать весь поток дальше, чтобы решения принимала LLM.
«Мы создали Deep Hat Sift, чтобы операционная команда могла доверить ему решение о том, что можно пропустить. Фильтрация не начинается, пока человек не утвердит порог; если качество падает, система открывает поток и отправляет всё на оценку LLM».
Kindo описывает Sift как специализированную модель для конкретного источника данных, целевого агента и задачи фильтрации. По заявлению компании, крупное предприятие может одновременно запускать сотни тысяч таких моделей — каждая будет подстраиваться под собственный поток.
Где компания предлагает применять Sift
Система рассчитана на источники, которые уже используют инженеры: оповещения SIEM и EDR, очереди заявок и сигналов, системные и сетевые журналы, инструменты мониторинга New Relic, Splunk и Datadog, а также потоковые системы вроде Kafka.
Среди основных сценариев Kindo называет всплески оповещений, сортировку сигналов и заявок, обработку потоков журналов и сообщений о фишинге. В реальном времени Sift также может проверять потоки событий на нарушения политик и признаки мошенничества для команд по соответствию требованиям и финансового контроля. Модель работает внутри инфраструктуры заказчика, в том числе в изолированных от внешних сетей средах, востребованных в оборонной и регулируемых отраслях.
Deep Hat Sift пополнила линейку Deep Hat — моделей и дополнений Kindo для более доступного и подконтрольного запуска LLM и агентов. В неё также входит Deep Hat Attack для тестирования защищённости. Kindo утверждает, что крупные разработчики универсальных моделей ограничивали применение таких систем для санкционированного тестирования на проникновение либо предлагали его по высокой цене. Deep Hat Attack создана для этой задачи и предусматривает участие человека.
Глава Kindo Рон Уильямс представил продукт как ответ на растущие расходы и ограниченный выбор: использовать большую модель для каждого события либо полагаться на простой фильтр с фиксированными настройками, который сложно контролировать.
Экономия здесь возникает не от более дешёвого ответа LLM, а от событий, которые до неё вообще не доходят. Но чем активнее фильтрация, тем важнее измерять пропуски и иметь безопасный режим отказа: иначе сокращение расходов превращается в слепую зону. Ценность Sift зависит от того, насколько убедительно работает этот контроль.
Масштабирование агентов и цена ошибок
Анонс появился на фоне давления на ИТ- и финансовых руководителей, которым приходится обосновывать затраты на агентов. В материале приводится прогноз Gartner®: к 2028 году в средней глобальной компании из списка Fortune 500 будет использоваться более 150 тысяч агентов — против менее чем 15 в 2025 году. Такое расширение, прогнозирует Gartner, приведёт к разрастанию парка агентов, усложнению ИТ-инфраструктуры и проблемам управления.
Kindo называет отказ от ненужных обращений к LLM отдельным рычагом контроля затрат и производительности. Идея состоит не только в более эффективном использовании модели, но и в том, чтобы вовсе не запускать её, когда событие этого не требует.
В материале также приводится исследование Gartner за сентябрь 2026 года о так называемых агентах-наблюдателях — системах, которые контролируют работу других ИИ-агентов. Если LLM-агент выполняет десять вызовов для планирования, работы с инструментами и других действий, а вероятность ошибки на каждом шаге составляет 10%, итоговая задача будет успешно выполнена лишь примерно в трети случаев, указывает Gartner.
«Агенты-наблюдатели используют детерминированные правила и экономичные технологии, например малые языковые модели, для задач с низкой и средней неоднозначностью, передавая человеку только сложные отклонения».
Kindo говорит, что Deep Hat Sift создавался как такой фильтрующий слой: он должен отправлять к LLM только необходимые события. Компания позиционирует продукт одновременно как средство сокращения затрат и способ повысить надёжность многошаговых процессов, в которых ошибка на одном этапе может повлиять на результат всей задачи.
Оставить комментарий