
Оглавление
Исследователи из Polymathic AI, Принстонского университета, USC ISI, Нью-Йоркского университета и Flatiron Institute представили FlashMap — метод ускорения генерации текста большими языковыми моделями. По данным MarkTechPost, на модели Qwen3-8B он показал ускорение до 6,14 раза без изменения итогового ответа по сравнению с обычным декодированием.
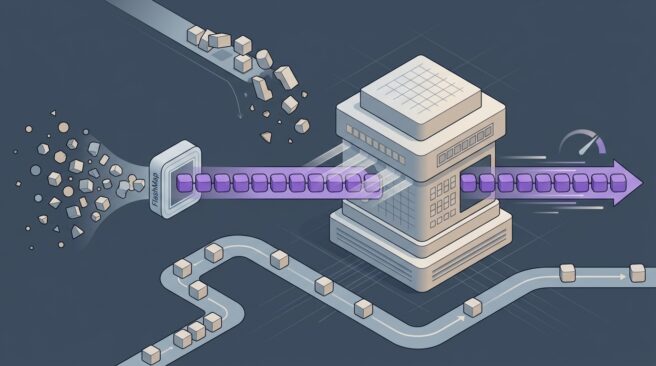
FlashMap использует спекулятивное декодирование: небольшая модель-«черновик» предлагает несколько следующих токенов, а основная модель проверяет их параллельно и принимает самый длинный подходящий фрагмент. Результат остаётся таким же, каким его выдала бы основная модель, но генерация может идти быстрее. FlashMap за один проход предлагает блок из 16 токенов, причём старается учитывать связи между ними.
Размер черновой модели составляет 500 млн параметров для Qwen3-8B и 475 млн для Qwen3-4B. Она работает на том же графическом процессоре, что и основная модель. В тестах авторов использовался один NVIDIA H200 NVL, параллельность запросов 1 и формат bf16. Максимальное ускорение — 6,14 раза на GSM8K при температуре 0; средняя длина принятого фрагмента там составила 7,69 токена. На Alpaca при температуре 1 результат был скромнее — 2,28 раза. На Qwen3-4B при температуре 0 FlashMap уступил DFlash в четырёх из девяти задач.
Как FlashMap сохраняет связи между токенами
Предыдущий подход DFlash также формирует блок целиком за один проход, но предсказывает каждую позицию независимо. Это называется факторизованным приближением. Если вероятны продолжения «Нью-Йорк» и «Сан-Диего», независимые предсказания могут собрать ошибочные сочетания «Нью-Диего» или «Сан-Йорк»: основная модель отклонит такой вариант уже со второго токена.
FlashMap строит блок иначе: один образец шума преобразуется в последовательность токенов, а выбор одного варианта продолжения влияет на весь блок. Метод опирается на Flow Map Language Models — модели, которые отображают шум в данные. Авторы утверждают, что такой подход лучше сохраняет совместимость токенов внутри черновика.
Черновик FlashMap — диффузионный трансформер из шести блоков, с размерностью вложений 2048 и 16 головами внимания. Он получает скрытые состояния основной модели из слоёв 1, 9, 17, 25 и 33. Матрица вложений и выходная языковая голова копируются из целевой модели и остаются замороженными, то есть при обучении не меняются.
Обучение проходило в два этапа. Сначала авторы подготовили «учителя» — непрерывный потоковый процесс над блоками токенов, обученный с перекрёстной энтропией. Для словаря Qwen3 размером 151 936 токенов применили перенастройку временной шкалы. Затем дистилляция полугруппы превратила этот процесс в «ученика»: двухвременной денойзер, который перескакивает от шума к данным за один шаг.
Обе версии черновика обучали на 500 тысячах примеров из Open-PerfectBlend. На все модели и эксперименты, включая абляции, ушло около 4600 часов вычислений на H200.
Результаты и сравнение с другими методами
В исследовании проверили девять задач по математике, программированию и диалогам при температурах 0 и 1. На Qwen3-8B однопроходный FlashMap показал наибольшую скорость среди тестируемых черновиков во всех задачах и при обеих температурах. По средней скорости он примерно на 7% опередил переобученный DFlash. По длине принимаемого фрагмента FlashMap превзошёл DFlash в 15 из 18 режимов и использует примерно вдвое меньше параметров.
При температуре 0 преимущество над DFlash составило 5,5% на математических задачах и 11,1% в диалогах. Двухшаговый FlashMap превзошёл DFlash по длине принимаемого фрагмента во всех 18 режимах, в среднем на 10%. При температуре 1 EAGLE-3 обеспечивал на 9% большую длину принятого фрагмента, но работал на 35% медленнее.
Отдельный тест с перемешиванием токенов проверял, действительно ли черновики используют связи внутри блока. Двухшаговый FlashMap восстановил большую часть выигрыша от совместной структуры, который показывала 16-шаговая модель-учитель; однопроходная версия сохранила лишь небольшую часть этого преимущества. Если генерировать дерево из четырёх образцов шума, среднее ускорение увеличивалось на 11%.
В сопоставимых испытаниях на Qwen3-8B при температуре 0 FlashMap показал среднее ускорение 4,36 раза, DFlash — 4,07, а EAGLE-3 — 2,55. На GSM8K показатели составили соответственно 6,14, 5,77 и 3,20 раза. Это повторные тесты авторов FlashMap на переобученных базовых методах; средние значения скорости рассчитаны ими по графику в статье.
Для контекста, в собственных заявленных результатах DFlash указывал ускорение до 6,17 раза на Qwen3-8B, а EAGLE-3 — до 6,5 раза. У DSpark заявлено сокращение времени на 60–85% относительно MTP-1, но в тестах FlashMap этот метод не сравнивали. По стилю генерации FlashMap использует непрерывное отображение потока за один или два прохода и совместно моделирует токены; DFlash — однопроходную блочную диффузию с независимыми позициями; EAGLE-3 строит дерево авторегрессивно; DSpark применяет полуавторегрессивную схему с лёгким последовательным модулем. Размер черновика для Qwen3-8B у переобученного EAGLE-3 — 302 млн параметров, у DFlash — 1 млрд; размер DSpark не раскрыт.
Главный технологический нюанс здесь не в рекордном числе ускорения, а в цене этого ускорения: FlashMap пытается улучшить долю принятых токенов, сохраняя блок компактным и быстрым для подготовки. Но тесты проведены на одной конфигурации, а на Qwen3-4B преимущество не универсально — выигрыш зависит от модели и задачи.
Установка и запуск
Пакет flashmap требует только torch и transformers версии 4.56 или новее; установить его можно командой uv pip install flashmap. Вызов spec_generate запускает черновую и основную модели на одном графическом процессоре.
Для работы с vLLM авторы указывают версию 0.31: путь к черновой модели передаётся через --speculative-config, а num_speculative_tokens устанавливается в 16. Для SGLang 0.5.20 предлагается алгоритм DSPARK с путём к черновику FlashMap. Параметр num_steps=2 позволяет обменять часть скорости на более высокую долю принятых токенов. При выборке с температурой выше нуля для vLLM требуется задать "draft_sample_method": "probabilistic".
Код проекта распространяется по лицензии MIT, веса — по Apache-2.0. Для работы заявлена поддержка Transformers, vLLM и SGLang; авторы также опубликовали веса для Qwen3-8B и Qwen3-4B.
Оставить комментарий