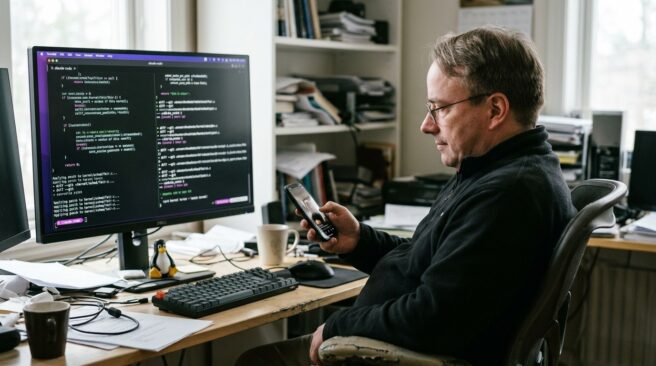

Создатель Linux Линус Торвальдс представил свой первый патч, разработанный с использованием больших языковых моделей (LLM), что стало знаковым событием для сообщества открытого ПО. Как сообщает издание Tom’s Hardware, предложенное решение направлено на устранение давней проблемы конкуренции кэша при одновременном чтении одного и того же файла множеством процессоров.
В ходе синтетических тестов новая разработка показала 23-кратный прирост производительности. Торвальдс, впрочем, сохраняет прагматичный скептицизм, отмечая, что в реальных сценариях эксплуатации цифры будут скромнее, так как типичные нагрузки редко достигают экстремальных значений бенчмарка. Тем не менее, оптимизация обещает стать ощутимым подспорьем для высоконагруженных серверов баз данных и веб-узлов.
От черновика к машинному коду
История этого исправления началась еще в начале 2024 года, когда Торвальдс опубликовал черновой вариант решения и тестировал его на личном ноутбуке. Несмотря на то что над проблемой годами бились разные разработчики, идеального универсального метода найти не удавалось. В итоге Линус решил «попробовать решить это по-настоящему, используя LLM», что привело к созданию текущей версии в ветке разработки.
Этот шаг логично продолжает текущую политику Торвальдса в отношении искусственного интеллекта. Ранее он уже выступал с жесткой критикой противников нейросетей в разработке, подчеркивая, что ИИ — это просто инструмент, подобный компилятору или текстовому редактору. По его мнению, автоматизированные средства проверки кода уже сейчас превосходят людей в обнаружении базовых ошибок программирования.
Использование LLM опытным архитектором для рутинной оптимизации — это не капитуляция перед машиной, а логичная эволюция инструментария. Однако 23-кратный рост в синтетике часто превращается в едва заметный процент в реальном продакшене из-за сложности системных вызовов. Опасность здесь кроется не в самом коде, а в иллюзии, что нейросеть может заменить понимание архитектуры ядра, превращая процесс разработки в конвейер по генерации красивого, но потенциально хрупкого кода. Линус лишь подтверждает статус-кво: ИИ хорош ровно настолько, насколько хорош его куратор.
Последствия для сообщества и безопасности
Переход к активному использованию нейросетей сопровождается важными изменениями в регламенте. Команда разработчиков Linux больше не требует обязательного признания в использовании ИИ-инструментов при подаче патчей. Главным критерием остается понимание автором того, что именно делает его код, и готовность нести за него ответственность в процессе жесткого рецензирования.
Однако массовое применение ИИ имеет и обратную сторону, создавая дополнительную нагрузку на мейнтейнеров. В текущем году список рассылки по безопасности Linux стал практически неуправляемым из-за потока автоматизированных отчетов об уязвимостях. Нейросети эффективно находят паттерны ошибок, что привело к фиксации около 2000 CVE на каждый релиз, вынуждая команду тратить огромные ресурсы на проверку этих данных.
Такая ситуация заставляет разработчиков отказываться от поддержки старого оборудования, которое чаще всего становится мишенью для автоматических «охотников за багами». В этом контексте пример Торвальдса выглядит как попытка задать правильный вектор: использовать интеллект машин для созидания и решения сложных архитектурных задач, а не только для бесконечного поиска мелких недочетов в легаси-коде.
Оставить комментарий