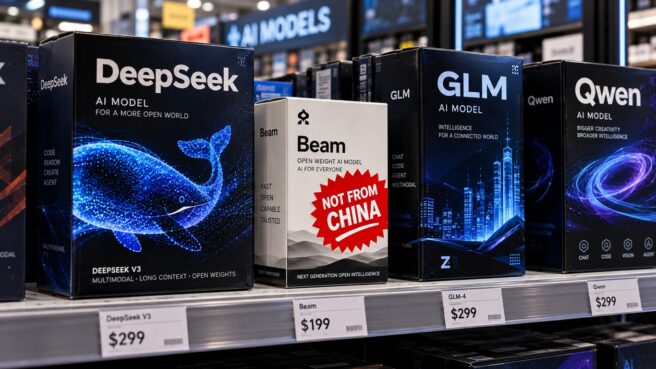

Стартап Reflection анонсировала выпуск своей первой открытой модели Beam, специализирующейся на программировании и логических рассуждениях. В отличие от многих конкурентов, компания сделала ставку не на абсолютные показатели производительности, а на исключительную вычислительную эффективность. По данным The Decoder, Beam позиционируется как прямой западный ответ доминирующим сегодня китайским открытым архитектурам вроде DeepSeek и Qwen.
Beam представляет собой архитектуру Mixture-of-Experts (смесь экспертов) с общим числом параметров 501 миллиард. Однако для обработки одного токена система активирует всего 23 миллиарда параметров. Такой подход позволяет существенно сократить операционные расходы, сохраняя при этом высокую точность выводов. В ходе тестов модель показала результаты, сопоставимые с GLM 5.2, потребляя при этом в три-четыре раза меньше вычислительных мощностей.
Масштабное обучение и умная экономия
Разработка Beam потребовала одного из самых масштабных циклов обучения с подкреплением (Reinforcement Learning) в истории открытых лабораторий. Стартап задействовал 10 500 графических процессоров Nvidia GB300 в течение месяца. Интересно, что показатели модели продолжали расти до самого конца обучения, не обнаруживая признаков выхода на плато, что намекает на наличие нераскрытого потенциала у текущей архитектуры.
Для практического применения разработчики внедрили настраиваемый параметр интенсивности рассуждений. Это позволяет пользователю выбирать между быстрыми ответами для простых вопросов и глубоким раздумьем для сложных архитектурных задач, обменивая время генерации на качество. В ходе обучения зафиксированы и эмерджентные способности: модель научилась эффективно искать информацию в сети и взаимодействовать с внешними сервисами, хотя эти навыки не закладывались напрямую.
Эффективность Beam — это не просто экономия серверных мощностей, а признак зрелости архитектуры Mixture-of-Experts, где количество параметров перестало быть единственным мерилом силы. Однако за громким титулом «самой мощной на Западе» скрывается лукавство: пока Beam догоняет китайские аналоги по эффективности, он все еще уступает им в чистой производительности на сложных бенчмарках. Мы видим отличный инженерный продукт, который, тем не менее, играет роль догоняющего в соревновании, где правила устанавливают Пекин и Кремниевая долина.
В таблице ниже приведено сравнение Beam с ведущими моделями в специализированных тестах на написание кода и работу агентов:
| Бенчмарк | Beam | GLM 5.2 | Qwen 3.8 Max | Kimi K3 |
|---|---|---|---|---|
| DeepSWE v1.1 | 44.4 | 44.0 | 51.0 | 68.0 |
| Terminal Bench v2.1 | 80.1 | 81.0 | 86.6 | 88.3 |
| SWEBench Verified | 80.9 | Н/Д | Н/Д | Н/Д |
Безопасность и планы на будущее
Для обеспечения безопасности Reflection использует гибридный подход: основная модель Beam объединена со второй специализированной нейросетью, отвечающей за соблюдение этических норм и фактическую точность. Разработчики обещают, что модель будет признавать отсутствие знаний в спорных ситуациях вместо того, чтобы галлюцинировать. Ожидается, что веса модели под лицензией Apache 2.0 станут доступны широкой публике до конца октября.
Проект ведут выходцы из Google DeepMind — Миша Ласкин и Иоаннис Антоноглу, которые привлекли около 2 миллиардов долларов инвестиций. Среди инвесторов значится Nvidia, что объясняет доступ к колоссальному количеству видеокарт. Хотя Reflection хранит данные обучения в секрете, открытие весов Beam может стать важным шагом для западных компаний, стремящихся к независимости от закрытых API и дорогостоящих китайских облачных решений.
Оставить комментарий