
Оглавление
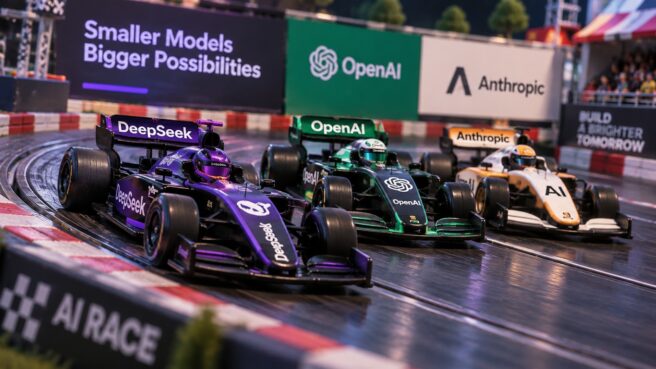
Китайская компания DeepSeek представила новую модель DeepSeek-V4.1-Flash, которая, несмотря на меньшее количество параметров по сравнению с флагманом V4-Pro, демонстрирует впечатляющее превосходство в скорости, стоимости и эффективности выполнения специализированных задач. Как сообщает thelec.net, разработчики уже начали процесс перевода своего API с версии V4-Pro на новую Flash-модель, позиционируя её как более практичную альтернативу для реальных сценариев использования.
В основе новинки лежит архитектура Mixture of Experts (MoE), однако инженеры DeepSeek пошли дальше стандартных решений, внедрив разделение активных параметров для разных этапов работы. В общей структуре модели заложено 552 миллиарда параметров, но при обработке входных данных (инференсе) задействуется всего 8 миллиардов, а при генерации ответа — 16 миллиардов, что позволяет радикально снизить вычислительные затраты без потери качества логики.
Архитектурные хитрости и вопросы производительности
Сравнение с конкурентами выглядит любопытно: в бенчмарке Terminal-Bench 2.1 при максимальной интенсивности рассуждений V4.1-Flash сумела обойти GPT-5.6 Sol от OpenAI и Claude Opus 5 от Anthropic. Однако стоит сохранять здоровую долю скепсиса, поскольку в более сложном тесте Terminal-Bench 4.0, включающем 66 комплексных задач из области машинного обучения и безопасности, модель все же уступила лидерам рынка. Это наводит на мысли, что «магия» Flash-версии пока лучше всего работает в строго очерченных границах программирования и автоматизации.
Платформа Artificial Analysis присвоила модели индекс интеллекта 40. Для контекста: это значительно выше медианы для открытых моделей (которая составляет 18), но ниже топовых проприетарных решений, чьи баллы после ужесточения методологии оценки сместились в район 50-55. Тем не менее, по показателю скорости генерации DeepSeek-V4.1-Flash выдает 214.4 токена в секунду, что почти в три раза быстрее среднего результата по рынку.
Архитектура CED с разделением энкодера и декодера — это изящная попытка обмануть физику KV-кэша, превращая линейную обработку в эффективный конвейер. Однако феноменальная разговорчивость модели и склонность к избыточным токенам могут быстро нивелировать экономию на стоимости API. Перед нами отличный инструмент для кодинга, который, впрочем, пока не готов стать универсальным цифровым разумом из-за просадок в сложных логических выводах.
Инновации в управлении памятью и этические риски
Особого внимания заслуживает технология Causal Encoder-Decoder (CED). В отличие от стандартных LLM, где понимание вопроса и генерация ответа происходят в одних и тех же слоях, DeepSeek разделила 40 слоев трансформера на 20 слоев причинного энкодера и 20 слоев декодера. Это позволило отказаться от ресурсоемкого механизма cross-attention, заменив его прямой проекцией финального состояния энкодера в кэш декодера. Дополняет картину метод SWA Bounded Replay, который удерживает в памяти только последние 128 токенов, пересчитывая локальный контекст на лету вместо хранения гигантских объемов данных на диске.
Хронология развития китайских нейросетей в последнее время омрачается серьезными обвинениями. Компания Anthropic недавно заявила, что DeepSeek, наряду с Alibaba и Moonshot AI, участвовала в несанкционированном сборе данных из моделей Claude для дистилляции — процесса обучения собственных систем на ответах более мощных «учителей». По данным Anthropic, зафиксировано около 12.1 миллиона взаимодействий, которые могли быть использованы DeepSeek для улучшения своих алгоритмов.
Несмотря на этические споры, технологический стек V4.1-Flash, включающий квантование FP4 и сжатое разреженное внимание CSA2, позволяет модели занимать выгодную позицию на «границе Парето». Это означает, что на данный момент она предлагает едва ли не лучшее соотношение цены и интеллектуальных возможностей для разработчиков, которым важна скорость сборки кода и автоматизация терминальных задач, а не философские беседы о будущем человечества.


Оставить комментарий