
Оглавление
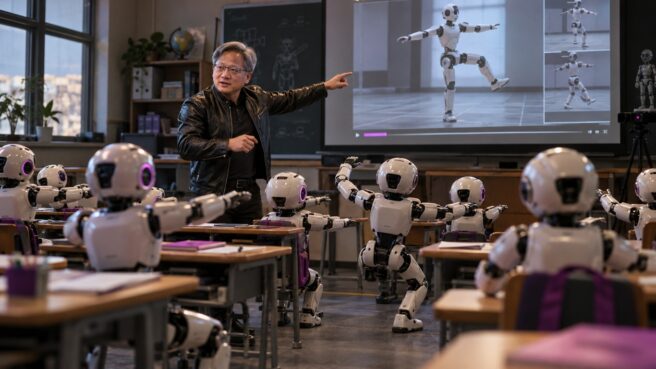
Компания Nvidia представила Flora — новый открытый движок для аннотирования данных, способный радикально снизить затраты на обучение роботов. Согласно официальным данным, обработка одного часа видео с помощью этой системы обходится всего в 0,72 доллара, в то время как использование проприетарной модели GPT-6 Astra от OpenAI для той же задачи стоит около 88,50 доллара. Как сообщает eGamers.io, такая разница в цене выглядит как убедительный аргумент в пользу специализированных решений.
Несмотря на впечатляющий разрыв в стоимости, стоит учитывать, что цифра в 72 цента является расчетной оценкой. Специалисты Nvidia вывели ее, исходя из стоимости аренды одного графического процессора в 10 долларов за час. В реальных производственных условиях итоговый чек будет зависеть от конкретных тарифов облачных провайдеров, однако масштаб экономии в любом случае остается существенным для индустрии роботов.
Архитектура из трех моделей Qwen
Технически Flora представляет собой каскад из трех дообученных моделей семейства Qwen 3.5. Первая, наиболее легкая модель (9B), отвечает за сегментацию видео на отдельные действия. Следом вступает модель среднего размера (27B), которая описывает каждый сегмент, опираясь на контекст предыдущих и последующих кадров. Завершает процесс Flora-Rewarder (также 27B), выполняющая роль судьи.
Последний компонент системы крайне важен для обучения с подкреплением. В зависимости от задачи он может оценивать успех выполнения операции по пятибалльной шкале, размечать каждый полусекундный шаг как «нормальный» или «субнормальный», а также проверять действия робота на соответствие заданным пользователем правилам. Это позволяет автоматизировать создание сигналов вознаграждения, которые раньше требовали ручного труда.
Сильные стороны и компромиссы точности
В тестах на обнаружение ошибок Flora показала себя неожиданно эффективно, зафиксировав 53,3% неудачных действий, в то время как Astra не справилась с этой задачей вовсе. Тем не менее, высокая чувствительность имеет свою цену: система склонна к ложным срабатываниям, принимая штатные ситуации за ошибки примерно в 11% случаев. На публичном бенчмарке WGO-Bench результаты оказались смешанными: Flora лидирует в определении границ действий, но уступает Gemini 3.8 Flash в точности текстовых описаний.
Любопытно, что в собственных тестах Nvidia модель Astra выступала одновременно и участником, и судьей, оценивающим качество описаний. Это создает определенный методологический нюанс, который исследователи честно признают в своем отчете. На длинных видеофрагментах Flora иногда теряет нить повествования, разбивая одно действие на слишком мелкие шаги или ошибаясь в сути происходящего — например, путая протирание тарелки со складыванием салфетки.
Nvidia в очередной раз мастерски упаковывает продажи своего «железа» в обертку открытого софта. Flora — это изящный способ заставить рынок генерировать петабайты данных, которые потребуют еще больше GPU для обучения. Проблема лишь в том, что точность разметки здесь принесена в жертву дешевизне: путать салфетку с тарелкой в лаборатории весело, но в реальном цеху такая «экономия» может стоить слишком дорого. Впрочем, для масштабирования обучающих выборок до сотен тысяч часов выбора у индустрии просто нет.
Стратегия открытых данных
Выпуск Flora в open source — это часть долгосрочной стратегии Nvidia по захвату рынка робототехники. Движок уже интегрирован в процесс обучения моделей серии GR00T, где он обрабатывает до 200 000 часов видео ежедневно на кластерах из 512 графических ускорителей GB300. Предоставляя бесплатные инструменты для подготовки данных, компания стимулирует разработчиков оставаться в своей экосистеме.
Параллельно свои решения развивает и Google, чья модель Gemini 4 Argon также нацелена на автоматизацию разметки видео для роботов. В этой гонке за «умными» данными победит не тот, кто создаст самую большую модель, а тот, кто предложит самый эффективный и дешевый способ превратить хаос видеозаписей в структурированный учебный материал для следующего поколения автономных машин.
Оставить комментарий