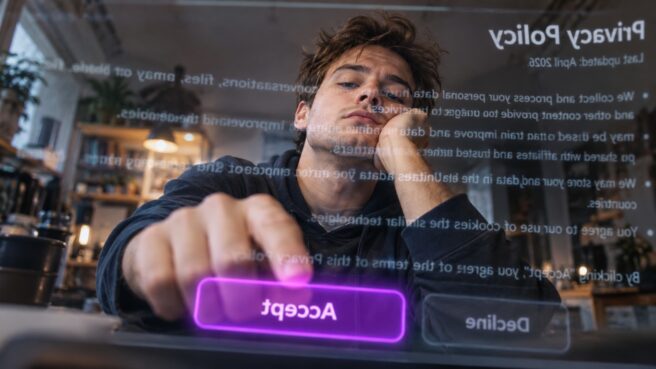

В эпоху стремительного развития технологий конфиденциальность данных часто приносится в жертву удобству, и недавнее исследование показало, что этот компромисс может быть более опасным, чем кажется на первый взгляд. Согласно материалу издания SC Media, политики конфиденциальности популярных больших языковых моделей (LLM) стали настолько громоздкими и сложными, что среднестатистический пользователь практически лишен возможности понять, на что он соглашается.
Специалисты по кибербезопасности из фирмы Bridewell провели детальный аудит юридических документов 20 ведущих сервисов на базе ИИ. Результаты оказались неутешительными: среднее время, необходимое для вдумчивого прочтения одного такого соглашения, составляет 20 минут. В некоторых случаях объем текста превышает 14 000 слов, что превращает процесс ознакомления в полноценное чтение лонгрида, написанного на сухом юридическом диалекте.
Для оценки доступности текстов использовался индекс удобочитаемости Флеша, где средний показатель составил всего 40.2 балла. Это свидетельствует о крайне высоком уровне сложности и перенасыщенности документации жаргоном. В профессиональной среде такие тексты принято называть «непроницаемыми», поскольку они эффективно скрывают критически важные детали за нагромождением терминов, понятных лишь узкому кругу юристов.
Где исчезает приватность ваших промптов
Проблема переходит из плоскости академического интереса в область реальных рисков, когда речь заходит об обучении моделей. Исследование выявило, что 13 из 20 изученных LLM по умолчанию используют вводимые пользователями данные и генерируемые ответы для дальнейшего совершенствования своих алгоритмов. При этом механизм отказа от такой обработки данных часто либо неочевиден, либо вовсе отсутствует в пользовательском интерфейсе.
Для корпоративного сектора это создает «серую зону» безопасности. Сотрудники компаний, стремясь оптимизировать рабочий процесс, могут непреднамеренно скармливать нейросетям конфиденциальную информацию, финансовые отчеты или фрагменты проприетарного кода. Впоследствии эти данные становятся частью общего набора знаний модели, что делает их потенциально доступными для воспроизведения в ответах другим пользователям, если механизмы фильтрации дадут сбой.
Сложность юридических формулировок в политиках конфиденциальности ИИ-сервисов — это не баг, а фича, позволяющая компаниям легитимизировать сбор данных без реального осознания рисков пользователем. Когда чтение условий занимает больше времени, чем сама работа с моделью, право на приватность превращается в формальность. Бизнесу пора признать: использование публичных LLM без корпоративных надстроек безопасности — это добровольная передача интеллектуальной собственности в общее пользование под прикрытием пользовательского соглашения.
Чтобы минимизировать риски, эксперты настоятельно рекомендуют компаниям внедрять строгие внутренние регламенты и переходить на использование корпоративных (Enterprise) аккаунтов. Такие версии сервисов обычно предусматривают юридические гарантии того, что данные клиента не будут использованы для обучения глобальных моделей, обеспечивая необходимый уровень изоляции информационных потоков.
В конечном итоге, ситуация с политиками конфиденциальности напоминает классическую дилемму разработчика: можно написать код быстро, а можно — понятно для тех, кто придет после тебя. Пока что создатели ИИ выбирают первый путь, оставляя вопросы прозрачности на откуп будущим регуляторам. Пользователям же остается либо тратить те самые 20 минут на изучение документов, либо смириться с ролью бесплатного поставщика данных для обучения технологий будущего.
Оставить комментарий