Министерство юстиции США выясняет, может ли покупка Nvidia платформы Hugging Face за почти $13 млрд повлиять на конкуренцию в сфере ИИ. В тексте также говорится о других претензиях властей к Nvidia: экспортных ограничениях, покупке SchedMD и сделке с Groq.
Капитализация Alphabet упала более чем на $500 млрд после квартального отчёта, который встревожил инвесторов из-за ИИ-сводок в поиске и роста расходов. Похожие опасения затронули Amazon, а Microsoft снизилась незначительно.
Что такое общий искусственный интеллект (AGI), как его по-разному определяют исследователи и компании и можно ли утверждать, что он уже появился, в том числе на примере модели GPT-6 Astra.
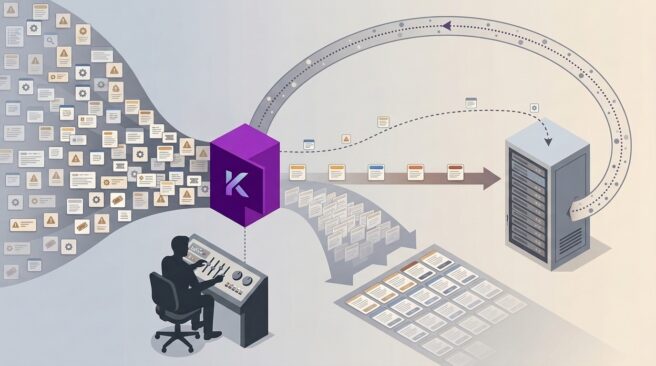
Kindo представила Deep Hat Sift, модель, которая отбирает события из потоков оповещений, заявок и журналов и решает, какие из них отправлять большой языковой модели, а какие можно пропустить. Так компания предлагает сократить расходы на обработку событий без отказа от ИИ-агентов.
DeepSeek и Moonshot AI заявили о заметном росте результатов своих языковых моделей после постобучения, без смены базовой архитектуры. Материал разбирает, что показывают тесты и почему постобучение становится важнее предварительного обучения.
Исследователи представили FlashMap, метод ускорения генерации текста большими языковыми моделями за счёт совместного черновика токенов. На Qwen3-8B он дал ускорение до 6,14 раза без изменения итогового ответа по сравнению с обычным декодированием.